ツール一覧 / AI活用ノート / プロンプトの型5つ|役割・入力・出力形式・制約・例の組み方
プロンプトの型5つ|役割・入力・出力形式・制約・例の組み方
プロンプトを「役割・入力・出力形式・制約・例」の5つに分解し、それぞれビフォー/アフターで書き換え方を整理しました。提供元3社の公式ドキュメントを読み比べ、どの型から直すと出力が安定するかまで踏み込みます。
同じ依頼文を3回投げて、3回とも違う形で返ってきた。見出しが付いたり付かなかったり、勝手に「以下にまとめます」から始まったり。そこで「あなたはプロのライターです」を足してみたけれど、形は揃わなかった——この順番で詰まった人に向けて書いています。
直す順番はこうです。形が揃わないなら「出力形式」と「例」から。中身が薄いなら「入力」。長さや脱線が問題なら「制約」。「役割」は最後。役割を足しても事実の正確さは上がらない、という検証が出ています。そして5つ全部を盛れば強くなるわけではありません。
この記事の目次
プロンプトを分解すると、だいたい5つに落ち着く
この5つは誰かの発明ではなく、提供元3社のドキュメントを並べると自然に浮かび上がる区分です。OpenAIは開発者向けメッセージの構成として「Identity(目的や口調)/Instructions(守るルール)/Examples(入出力のペア)/Context(追加情報)」の順に並べることを挙げています。Anthropicは「明確で直接的に」「例を効果的に使う」「XMLタグで構造化」「役割を与える」を並べ、Googleは「明確で具体的な指示」「制約を指定する」「文脈情報を足す」「few-shot例を入れる」を挙げています。呼び名は違っても、指しているものはほぼ重なります。
選定基準:何をもって「効く」と言っているか
順番を出す前に、基準を先に置きます。この記事で「効く」と呼んでいるのは、次の3つを満たすものです。
- 提供元3社(Anthropic / OpenAI / Google)の公式ドキュメントが、揃って推奨しているか
- 出力の「形」が変わると明文化されているか(気分の問題ではなく、再現する変化か)
- 第三者の検証で効果が測られているか、または測ったうえで否定されているか
逆に、この記事では「なんとなく良くなった気がする」は採用していません。以下の並びは、この3基準に照らした結果です。
手をつける順番は「出力形式 → 例 → 入力 → 制約 → 役割」
拾い読みする人のために先に書くと、一番コスパがいいのは出力形式の一行です。書き足すのに10秒、効果は毎回出ます。役割を最後に置いたのは、効かないからではなく、効く範囲が文体に限られるからです。
| 型 | 一行で言うと | 直すと変わるもの | 書く手間 |
|---|---|---|---|
| 出力形式 | 「表で。前置きなし」 | 形式のばらつき | 1行 |
| 例 | 「こう書いて」を3つ見せる | 形式・語彙・粒度 | 5〜15分 |
| 入力 | 手元の資料を貼る | 事実の精度 | 貼るだけ |
| 制約 | 「400字以内。専門用語は使わない」 | 長さ・脱線 | 1〜2行 |
| 役割 | 「あなたは編集者です」 | 語り口 | 1行 |
← 表は横にスクロールできます →
型1・役割:文体は変わる。正答率は変わらない
「あなたはプロの◯◯です」を足しても、難しい問題の正解率は上がりません。2026年9月14日時点でarXivに公開されている検証報告(Prompting Science Report 4)は、GPQA DiamondとMMLU-Proという大学院レベルの問題群で6つのモデルを試し、専門家ペルソナを与えても無ペルソナの場合と比べて精度は概ね改善しなかったと報告しています。分野が噛み合わないペルソナはむしろ下げることがあり、「子ども」「素人」といった知識の少ないペルソナは精度を落とす傾向があったとされています。
では無意味かというと、そうではありません。Anthropicは「システムプロンプトで役割を設定すると、用途に合わせて振る舞いと口調が絞られる。一文でも違いが出る」と書いています。つまり役割は、精度のスイッチではなくトーンのつまみです。ここを取り違えたまま役割文を膨らませても、報告書の数字は良くならない。個人的には、この整理がいちばん腑に落ちました。役割を足して手応えを感じるのは、たいてい同時に語彙と視点が変わっているからです。
ビフォー
あなたは世界最高峰のマーケティング専門家です。以下を分析してください。
アフター
中小企業の販促担当者に向けて、専門用語を使わずに説明してください。
役割名で権威づけするより、「誰に向けて」「どの語彙で」を書いたほうが、返ってくる文章の読み手が実際に変わります。
型2・入力:モデルが持っていない情報は、こちらが渡す
Googleのプロンプト設計ドキュメントは、ここを「モデルが必要な情報をすべて持っていると仮定するのではなく、問題を解くのに必要な指示と情報をプロンプトに含める」と説明しています。当たり前に聞こえますが、抜けやすいのは「社内にしかない情報」です。料金表、過去の議事録、クライアントの禁止ワード。
貼り方にもコツがあります。Anthropicは長い資料はプロンプトの上、質問や指示より前に置くことを推奨していて、「すべてのモデルで性能が上がる」と明記しています。複数の資料を渡すときは、それぞれを<document>タグで囲み、中に<document_content>と<source>を入れる形を挙げています。
ここは実務で地味に困るところで、Googleの開発者フォーラムには「動的で会話的でない状態情報を渡す、一級の手段が文書化されていないように見える。ラベル付きのセクションをContentの中に置くのが今の想定なのか」という投稿がありました。回答も「systemInstructionにラベルの扱い方をルールとして書く」という運用回避で、資料の渡し方は各社ともまだ運用でカバーする領域です。
型3・出力形式:「するな」より「こうしろ」
5つのうち、一番すぐ効くのがここです。Anthropicは出力形式の制御について、「してほしくないことではなく、してほしいことを伝える」を最初に挙げています。挙げられている例がそのまま分かりやすい。「マークダウンを使うな」ではなく「なめらかにつながる散文の段落で構成してください」。
もう1つ、知っておくと得なのがプロンプト自身の書き方が出力に移るという指摘です。Anthropicは「プロンプトで使った書式のスタイルが、応答のスタイルに影響することがある。プロンプトからマークダウンを取り除くと、出力のマークダウン量が減ることがある」と書いています。箇条書きだらけの指示文を投げて箇条書きが返ってくるのは、半分は自分のせい、ということになります。
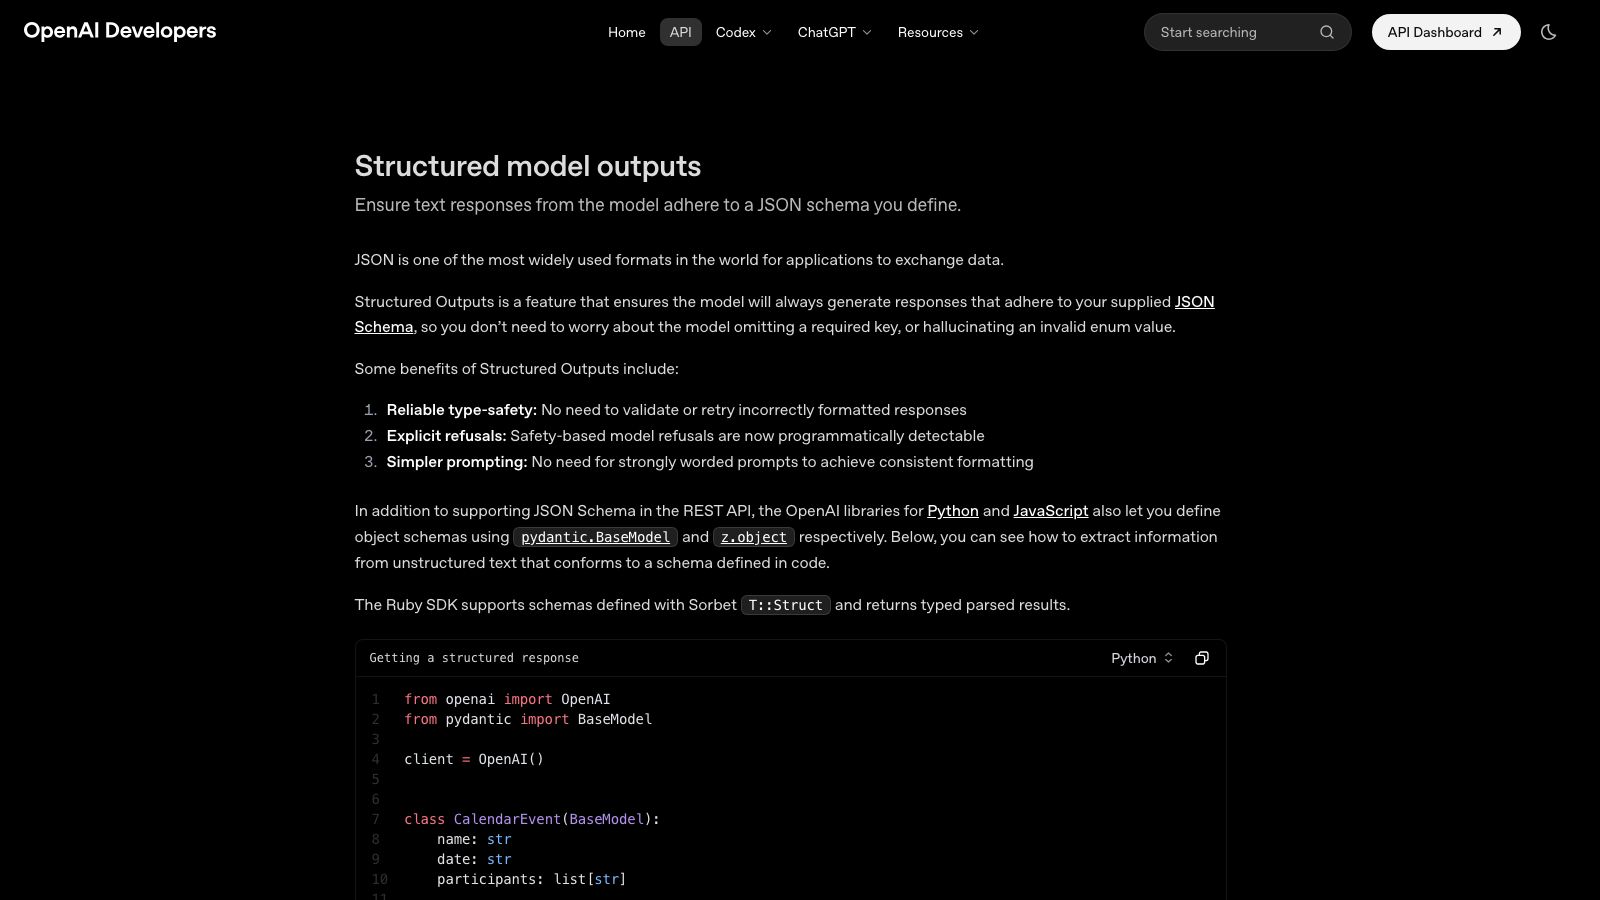
機械的に処理したいなら、文章での指示より仕組みを使ったほうが確実です。OpenAIのStructured Outputsは「モデルは常に、渡したJSON Schemaに従った応答を生成する。必須キーの欠落や不正なenum値を心配する必要がない」とされていて、JSONモードとの違いは「両方とも妥当なJSONを保証するが、スキーマへの適合を保証するのはStructured Outputsだけ」と明記されています。「JSONで返して」と念押しを重ねるより、スキーマを渡す。これは書き方の問題ではなく機能の問題です。
型4・制約:ここだけ3社の言い分が割れている
制約は「長さ・禁止事項・スコープ」を数字で書く型です。Googleは「プロンプトの読み方や応答の生成に関する制約を指定する。してよいこととしてはいけないことの両方を伝えられる」と書いています。一方でAnthropicは、先ほどの通り「してほしくないことではなく、してほしいことを伝える」を推しています。
この食い違いは放置せず、そのまま書いておきます。禁止事項を書くなら、理由をセットにするのが折衷案になりそうです。Anthropicのドキュメントには分かりやすい比較があって、「三点リーダーを絶対に使うな」より「この応答は読み上げエンジンで音声化されるため、三点リーダーは発音できません。だから使わないでください」のほうが効果的だとしています。理由を書けばモデルが一般化できる、という説明です。
ビフォー
長すぎないように。専門用語はNG。宣伝っぽくしないで。
アフター
・全体1,200字以内、1段落は3文まで
・専門用語は初出で10字程度の説明を添える
・読者は初めて導入を検討する人。契約を促す文は入れない
もうひとつ、2026年9月14日時点で押さえておきたい変化があります。Anthropicは、CLAUDE 4.6以降のモデルではシステムプロンプトへの反応が強くなっているため、「CRITICAL: あなたは必ず〜しなければならない」のような強い言い回しは、むしろ過剰に反応させると書いています。推奨は「Use this tool when...」程度の普通の書き方に戻すこと。強調記号を盛る癖がある人(私も他人事ではない)は、ここは削る方向に倒したほうがよさそうです。
型5・例:3〜5個。増やしすぎると例に寄る
例は、言葉で説明しづらいものを一発で伝えられる型です。Anthropicは「例は、出力形式・トーン・構造を導く最も信頼できる方法のひとつ」とし、3〜5個を推奨しています。条件は3つ。実際の用途に近いこと(Relevant)、エッジケースを含みばらけていること(Diverse)、<example>タグで囲んで指示と区別できること(Structured)。
Googleは「few-shot例は常に入れることを推奨する。例のないプロンプトは効果が下がりやすい」と踏み込んだうえで、「例を入れすぎると、モデルが例に過適合することがある」とも書いています。さらに「例の構造と書式は揃える。バラバラだと望まない形式で返ってくる」。
ビフォー
商品説明を、親しみやすい感じで書いてください。
アフター
<examples>
<example>
入力: 保温マグ 400ml
出力: 朝入れたコーヒーが、昼の休憩まで温かい。400mlは、マグ2杯分です。
</example>
<example>
入力: 折りたたみ傘 180g
出力: 180gは、スマホより軽い。バッグに入れっぱなしでも忘れます。
</example>
(あと1〜3件、同じ形式で)
</examples>
「親しみやすく」は人によって意味が違いますが、この2つを見せれば、数字を日常の単位に置き換えるという規則が伝わります。形容詞で頼まず、実物を見せる。5つの型のうち、書くのに一番時間がかかるのはここですが、同じ作業を週に何度もやるなら、15分の投資で毎回の手直しが減ります。
5つ全部盛りにすると壊れる場所
ここからは、あまり書かれていない話です。型を全部詰め込むと、逆に噛み合わなくなるポイントが3つあります。
ひとつめ。構造化出力とfew-shot例の相性が、まだ整理されていません。OpenAIの開発者コミュニティには「ユーザーとアシスタントのやりとりの形で、例をきちんと組み込む方法がない」という投稿があり、システムメッセージの中に文字列として例を埋めるのが実務上の回避策になっている、という議論が続いています。スキーマは機能で保証できても、「こういうトーンで」は例でしか伝わらない。その2つを同時に使う道が細い、という話です。
ふたつめは前述の強調しすぎ問題。みっつめが、書き出しの指定方法です。応答の先頭をこちらが書いておいて続きを書かせる「プレフィル」という手は、長らく形式固定の定番でしたが、Claude 4.6以降のモデルでは非対応とされ、送るとエラーが返るとAnthropicのドキュメントに書かれています。代わりの手段として挙げられているのは「前置きなしで直接答えてください。『以下は〜』のような書き出しは使わないでください」という直接の指示、XMLタグでの出力指定、構造化出力、ツール呼び出しです。
言い換えると、古い小技は順に潰れていて、残っているのは「はっきり書く」「形を指定する」「例を見せる」という地味な3つです。この記事の順番が出力形式・例・入力から始まるのは、そういう理由でもあります。
よくある質問
Q. 5つ全部を毎回書く必要はありますか。 ありません。形がぶれているなら出力形式と例、中身が薄いなら入力、というふうに症状から入るほうが早いです。Anthropicのドキュメントも「成功の基準を定め、それを検証する手段を持ってから」プロンプト改善に入ることを前提にしています。
Q. 「あなたはプロの◯◯です」は書かないほうがいいですか。 書いても害はほとんどありません。ただし正答率のためではなく語り口のためだと割り切ってください。分野の合わない専門家役や、知識の少ない役を振ると精度が落ちる傾向が報告されているので、「役を盛る」方向には行かないほうが安全です。
Q. 例は何個がちょうどいいですか。 Anthropicは3〜5個を挙げています。Googleは数を明示せず「実験して決める」としつつ、多すぎると例に過適合すると注意しています。まず3つ、形式を完全に揃えて置く。それで足りなければ足す、が現実的です。
Q. 日本語のプロンプトでも同じですか。 公式ドキュメントは言語を限定していません。ただし「プロンプトの書式が出力に移る」という指摘は日本語でも同じように働くので、欲しい文章の体裁で指示を書くのは試す価値があります。散文が欲しいなら、指示文も散文で書く。
Q. 無料プランでも試せますか。 5つの型はどれもプロンプトの書き方の話なので、追加費用はかかりません。スキーマで出力を保証するStructured OutputsのようなAPI側の機能だけは開発者向けの環境が必要です。まずは無料の範囲で、出力形式と例の2つを直すところから始めれば足ります。
この記事のまとめ
- プロンプトは「役割・入力・出力形式・制約・例」の5つに分解できる。3社の公式ドキュメントは呼び名が違うだけでほぼ同じ区分
- 直す順番は出力形式 → 例 → 入力 → 制約 → 役割。出力形式は1行で書けて毎回効く
- 役割は文体を変えるが、専門家ペルソナが事実の正確さを上げるという結果は出ていない
- 例は3〜5個、書式を完全に揃える。増やしすぎると例に寄りすぎる
- 禁止形の指示は、理由を添えるか「してほしい形」に言い換える。強調しすぎは新しいモデルで逆効果
次にやることを1つだけ挙げるなら、いま使っている定番プロンプトの末尾に「前置きなしで、表だけを返してください」のような形式の一行を足してみることです。効果が出るかどうかを、一番少ない手数で確かめられます。
出典
- Prompting best practices(Claude Docs)Anthropic / 2026-09-14参照
- Prompt engineering overview(Claude Docs)Anthropic / 2026-09-14参照
- Prompt engineering(OpenAI API Docs)OpenAI / 2026-09-14参照
- Structured Outputs(OpenAI API Docs)OpenAI / 2026-09-14参照
- Prompt design strategies(Gemini API)Google / 2026-09-14参照
- Prompting Science Report 4: Playing Pretend: Expert Personas Don't Improve Factual AccuracyarXiv(ペンシルベニア大学ウォートン校ほか) / 2026-09-14参照
- 「構造化出力にfew-shotをどう入れるか分からない」という開発者の投稿OpenAI Developer Community / 2026-09-14参照
- 「動的な文脈の入れ方に一級の手段がない」という開発者の投稿Google AI Developers Forum / 2026-09-14参照