ツール一覧 / AI活用ノート / Perplexityと普通の検索の違い|出典リンクの確かめ方
Perplexityと普通の検索の違い|出典リンクの確かめ方
Perplexityは出典つきで答えますが、出典があることと内容が正しいことは別です。国際調査の実データをもとに、出典リンクの3つの壊れ方、30秒でできる検証手順、断定的な要約が危ない場面を実例で整理します。
提案書に数字を入れる前の下調べなら、Perplexityで当たりをつけて、出典を自分で開く。ここまでが1セットです。
そのまま資料に引用するなら、出典を開くだけでは足りません。「その主張がそのページに書いてあるか」まで見ます。
一番抜けやすいのは3つ目。リンクが開けた時点で安心してしまうところです。
この記事の目次
Perplexityと普通の検索、読者側の作業はどう変わるのか
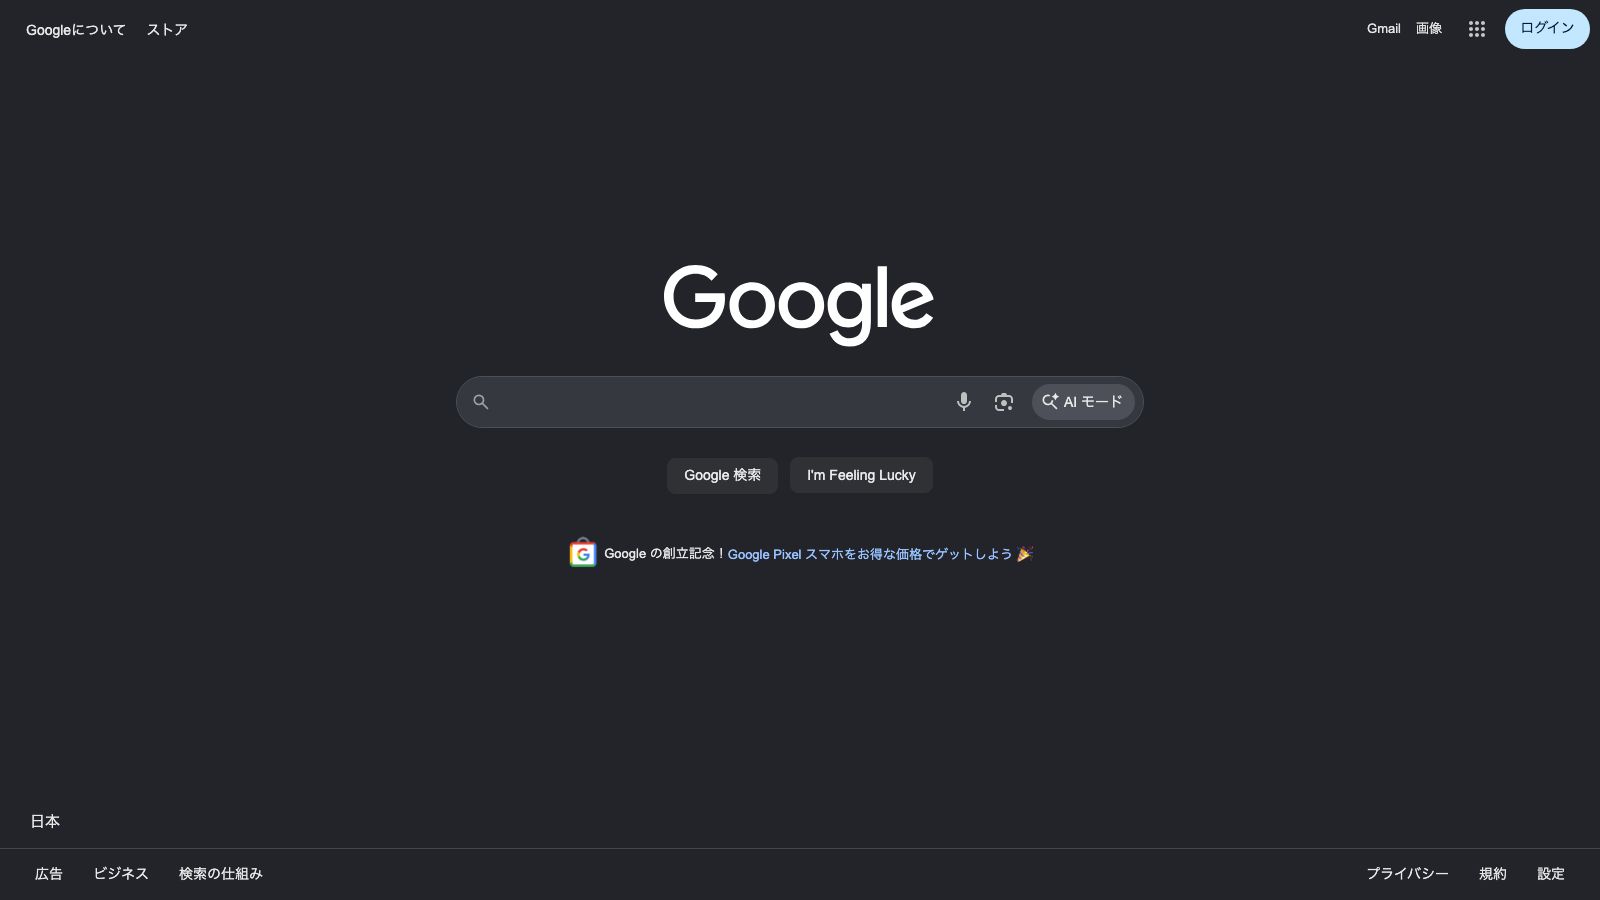
同じ「調べる」でも、手を動かす順番が逆になります。Googleは候補のリンクが並び、どれを開いて読むかをこちらが決める。Perplexityは先に答えの文章が出てきて、番号つきの出典がその後ろに付く。
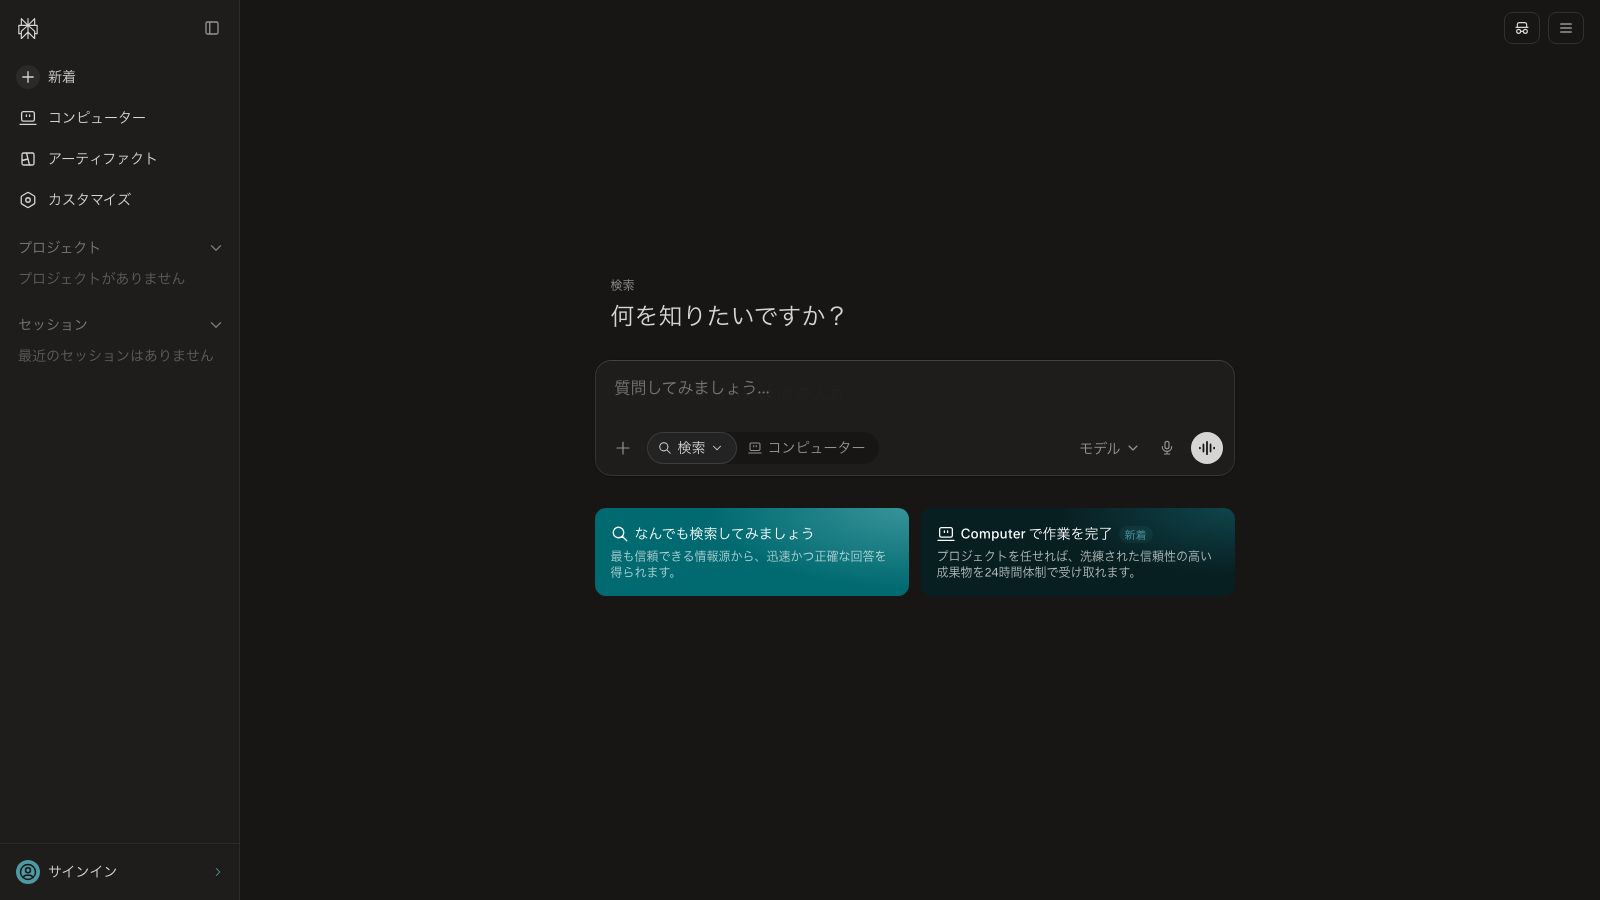
Perplexityは自社のAPIドキュメントで、自らを「web-grounded answers with built-in citations(出典が組み込まれた、ウェブに基づく回答)」を返すものと説明しています。ここで言う grounded は「ウェブを実際に検索して答えている」という意味であって、「内容が検証済み」という意味ではありません。この差が、あとで効いてきます。
何を基準に比べたか
この記事で「どのサービスが外しやすいか」に触れるので、先に基準を書きます。使ったのは次の3つだけです。
- 出典が実在するか(URLが開けるか)
- 出典がその主張を支えているか(リンク先に本当にその話が書いてあるか)
- 調査の一次資料が公開されているか(第三者が数字を追えるか)
使用感、速度、UIの好みは基準に入れていません。値段も入れていません。「出典つき回答をどう読むか」という一点に絞っています。
「出典がついている」と「正しい」は別物
ここが記事の本題です。番号つきリンクが並んでいると、裏取り済みの文章に見える。でも実測されている数字はそれを支持しません。
スタンフォード大のNelson F. Liuらは2023年、Perplexityを含む生成型検索エンジン4種を人手で監査しました。結果は、引用の精度(citation precision)が74.5%、引用の再現率(citation recall=出典で完全に裏付けられた文の割合)が51.5%。論文はこう書いています——回答は「流暢で有益に見えるが、裏付けのない記述と不正確な引用を頻繁に含む」。文の半分弱は、付いている出典では支えきれていなかったということです。
これは2023年の調査で、当時のPerplexityは今のものとは別物です。ただ、構造的な問題は最新の調査でも消えていません。
EBU(欧州放送連合)とBBCが2025年10月に公表した国際調査では、18か国・14言語の公共放送22社の記者が、無料版のChatGPT・Copilot・Gemini・Perplexityの回答2,709件を評価しました。全体の45%に「重大な問題」が1つ以上あり、その最大の原因が出典(31%)でした。
フィンランドのYleの評価者が使った言葉が、個人的には一番刺さりました。
多くの回答には「儀礼的な引用(ceremonial citations)」とでも呼ぶべきものが含まれている。入念に調べたという印象を作るために付けられた参照だが、確認すると実際には述べられた主張を支えていない。
「儀礼的な引用」。これ以上うまい言い方を私は思いつきません。
出典リンクは、3通りの壊れ方をする
壊れ方を分けておくと、確認作業が速くなります。同じ「出典がおかしい」でも、必要な対処が違うからです。
①開けないは、実は測定されています。ペンシルベニア大のDelip Raoらが2026年4月に公開した調査(arXiv:2604.03173)は、10モデル53,090件のURLと、3モデル168,021件のURLを対象に、引用URLが実際に生きているかを機械的に検査しました。結果、引用URLの3〜13%が「ハルシネーション」——Wayback Machineに一度も記録がなく、そもそも存在したことがないURL——で、5〜18%が開けないURLでした。
この調査は「開けるかどうか」しか見ていません。それでもこの率です。
②開けるが無関係の実例は、EBUの報告書にそのまま載っています。ベルギーのVRTが「なぜメキシコ湾がアメリカ湾に変わったのか」と質問したとき、Perplexityは9件のVRT記事を出典として並べました。うち本文で参照されたのは3件。残りには、一等車の廃止に関する記事、オランダの発電所の記事、そして2012年のおたふく風邪の流行に関する記事が含まれていました。
③関連するが、その主張だけ書かれていない。これが一番厄介です。ドイツのARDが「オルバーンは独裁者か」と聞いたとき、Perplexityは「ARDのTagesschauが彼の統治を権威主義的・非自由主義的と評している」と答えました。引用されたTagesschauの記事に、その記述はありませんでした。
リンクは生きている。発行元も本物。話題も合っている。それでも、その一文だけが無い。クリックして「あ、ちゃんとTagesschauだ」で終わると、これは通過します。
出典を確かめる手順(30秒〜2分)
全部の出典を検証していたら、AI検索を使う意味がありません。私が調べた範囲で妥当だと思う落としどころは、「資料に書く主張の数だけ確認する」です。回答が10個の出典を挙げていても、こちらが使う数字が2つなら、確認するのは2つです。
STEP 3が効きます。ブラウザの「ページ内検索」に、回答が言っていた数字や固有名詞をそのまま貼り付ける。1件あたり10秒ほどです。ヒットしなければ、そのページはその主張を支えていません。
STEP 4まで行くかは、用途次第です。社内のSlackで共有するだけなら3で止めて構いません。クライアントに出す資料なら、報道の先にある元の発表資料まで行っておく。Tow Centerの調査は、AI検索が元記事ではなくYahoo NewsやAOLへの転載版を提示する傾向を指摘しています。転載版は元の発表と食い違うことがあるので、この一手間は無駄になりません。
断定的な要約が危ないのは、こういう場面
EBUの報告書で、調べていて一番ぞっとした実例がこれです。
ジョージアの公共放送GPBが「イーロン・マスクはナチス式敬礼をしたか」と質問しました。Perplexityの回答は——「1tv.geの情報源にイーロン・マスクがナチス式敬礼を使ったという情報はありません……したがって、1tv.geによれば、イーロン・マスクはナチス式敬礼をしませんでした」。
GPBの評価者はこう書いています。
これは論理の誤りだ。1tv.geがこの件について何の情報も提供していないのなら、出来事を肯定する根拠としても否定する根拠としても引用できない。アシスタントは報道がないことを否定の証拠と誤って推論しており、情報源を歪め、事実として確定しているかのような誤解を与えている。
「情報が見つからない」と「事実ではない」は、まったく違う結論です。人間の記者なら「確認できていません」と書くところを、AIアシスタントは断定で埋めてしまう。
EBUはこれを「過信の問題」として1章を割いています。今回の調査では、全3,113問のうち回答を拒否したのはわずか17問(0.5%)。BBCの前回調査時の3%から下がっています。NewsGuardの観測でも、チャットボットがリアルタイム検索を導入するにつれて回答を断るのをやめ、無回答率は2024年8月の31%から2025年8月には0%まで落ちたとされています。答えられないときに答えなくなるのではなく、答えられないときも答えるようになった、ということです。
BBCの評価者のコメントが端的でした。
良い記者なら「我々が真実だと分かっていることの限界」を説明するところを、AIは単純で正確な「分かりません」で答えることに失敗し、説明で隙間を埋めようとする。
実務的な見分け方はひとつです。言い切っている文ほど、出典を疑う。 「〜とされています」より「〜ではありません」のほうが危ない。
もうひとつ、笑えない例を。フランスのRadio Franceが「なぜ人々はテスラを嫌うのか」と聞いたとき、Perplexityは回答の一部を風刺コラムに基づいて組み立てました。「左派の家族の夕食にテスラで乗りつけると、今や敵意すら招きかねない」——それが風刺だという表示は、回答のどこにもありませんでした。事実ベースの答えの中に、ネタ記事が1段落だけ混ざる。出典のドメインだけ見ていると、これは通ります。
出典の数が多い回答ほど安心、ではない
出典が9件並んでいる回答と、3件の回答。前者のほうが丁寧に調べた気がしますよね。私もそう思っていました。データは逆を示しています。
Raoらの調査は、この点をはっきり測っています。gpt-5.1は1問あたり46.4件のURLを出し、開けないURLの割合は8.5%。gemini-2.5-proは1問あたり10.7件で4.2%。4倍以上の出典を出すモデルのほうが、2倍外していました。論文の結論はこうです——「引用の量は引用の質の代理指標にならない」。
同じ調査は、「ディープリサーチ」系のエージェントのほうが、単純な検索連携モデルより存在しないURLを出しやすいことも示しています。ハルシネーションURLの割合は、ディープリサーチ系10.7%に対し、検索連携モデル4.8%。長い時間をかけて何段階も検索する仕組みほど、途中で生成されたURLが混ざりやすいという解釈です。
ノルウェーのNRKの評価者も同じ感触を書き残しています。ミャンマー地震の死者数を尋ねたとき、Perplexityは19件のURLを末尾に付けましたが、本文で参照していたのは3件でした。NATOに関する質問では9件中3件。評価者の言葉では「回答の中で実際には参照していない長いURLリストを提供する」。
だから、出典の件数は判断材料になりません。見るべきは、自分が使う一文に、どの番号が付いているかです。
この使い方に課金は要るのか
結論から言うと、ここで書いた検証手順をやるのに有料プランは要りません。リンクを開いてページ内検索するのは、ブラウザの仕事です。
そもそもEBU・BBCの国際調査は、全ツールの無料版で実施されています。理由は報告書に明記されていて、「初期設定の、おそらく最も一般的な利用体験を再現するため」。無料版でPerplexityの重大な問題は30%、うち出典に関する重大な問題は15%でした。つまり、この記事で扱っている話は無料版の話です。
もうひとつ、Tow Centerの調査が見つけた地味に重い事実があります。有料版のほうが誤り率が高かった。同調査ではPerplexity無料版が37%の誤答率で8サービス中最も低く、Perplexity Proはそれを上回りました。有料版は「答えない」が減って「答える」が増えるぶん、間違いも増える、という説明がされています。金額に見合う精度が自動的についてくるわけではない、ということです。
個人向けプランの価格は改定が入るので、金額は公式の料金ページで最新をご確認ください。なお2026-09-11時点で公式ドキュメントに掲載されているAPI側の価格は、Search APIが1,000リクエストあたり5.00ドル、Agent APIのウェブ検索ツールが1回あたり0.0025ドルです。
よくある質問
Q. Perplexityは普通の検索の代わりになりますか。 当たりをつける用途なら置き換わります。検索語が思いつかないテーマで「何を検索すべきか」を知る使い方が一番向いています。逆に、公式の申請書式や料金表のように「そのページ自体が欲しい」ときは、普通の検索のほうが速いです。
Q. 出典のドメインが公式サイトなら信用していいですか。 ドメインは実在確認にしかなりません。上で挙げたARDの例は、出典が本物のTagesschau記事で、それでも該当の記述がありませんでした。ドメインを見たあと、ページ内検索まで進めてください。
Q. 日本語で聞いても精度は変わりませんか。 EBU・BBCの調査は14言語で行われ、報告書は問題が「体系的で、国境を越え、多言語にまたがる」と結論づけています。言語を変えれば解決する類の問題ではない、というのが現時点の一次情報の読み方です。
Q. どこで一番間違えやすいですか。 更新が速い話題です。同調査で重大な問題が多かった質問は「トランプは貿易戦争を始めているのか」(48%)「ミャンマー地震の死者は何人か」(47%)。逆に少なかったのは「イーロン・マスクの出身地は」(14%)のような、動かない事実でした。動いている話ほど、出典の日付を見る価値があります。
Q. 「情報がない」と言われたら、本当に無いのですか。 限りません。EBUの報告書には、Perplexityが「RTPには情報がない」と答えたが実際には記事が存在した例、ZDFやNRKについて同様に「扱っていない」と誤って述べた例が記録されています。その媒体のサイト内検索で直接確かめるほうが確実です。
この記事のまとめ
- Perplexityの出典は「実際にウェブを検索した」証拠であって、「内容を検証した」証拠ではない
- 出典の壊れ方は3種類。開けない/無関係/関連するが主張だけ無い。3つ目が最も見落とされる
- 検証は全件やらない。自分が資料に書く主張の数だけ、リンクを開いてページ内検索する
- 言い切っている文ほど疑う。「報道がない」を「事実ではない」に変換した回答は、実際に記録されている
- 出典の件数は品質の目安にならない。4倍多く出すモデルのほうが2倍外したというデータがある
次にPerplexityを開いたとき、資料に転記する予定の数字ひとつだけ、リンクを開いてページ内検索してみてください。10秒で終わります。そこで一度でも空振りしたら、この記事の話は自分の仕事の話になります。
出典
- We Compared Eight AI Search Engines. They're All Bad at Citing News.Columbia Journalism Review / Tow Center for Digital Journalism / 2026-09-11参照
- News Integrity in AI Assistants: An international PSM study(報告書本体・PDF)European Broadcasting Union / BBC / 2026-09-11参照
- Largest study of its kind shows AI assistants misrepresent news content 45% of the timeEuropean Broadcasting Union / 2026-09-11参照
- Detecting and Correcting Reference Hallucinations in Commercial LLMs and Deep Research Agents(arXiv:2604.03173)Delip Rao, Eric Wong, Chris Callison-Burch(University of Pennsylvania) / 2026-09-11参照
- Evaluating Verifiability in Generative Search Engines(arXiv:2304.09848)Nelson F. Liu, Tianyi Zhang, Percy Liang(Stanford University) / 2026-09-11参照
- Perplexity API - OverviewPerplexity AI / 2026-09-11参照
- Perplexity API - PricingPerplexity AI / 2026-09-11参照
- Perplexity API - ModelsPerplexity AI / 2026-09-11参照