ツール一覧 / AI活用ノート / AI文字起こし精度比較|Whisper・Notta・Googleを日本語の会議で
AI文字起こし精度比較|Whisper・Notta・Googleを日本語の会議で
日本語の会議音声で、Whisper・Notta・Google Speech-to-Textはどれくらい間違えるのか。公開されている評価値と各社の公式表記を並べ、自分の会議音声で誤りの数を数える手順までまとめました。
結論: 日本語の会議音声は、「整った発言」と「かぶった雑談」で誤りの量が数倍変わります。ツールを選ぶ前に、自分の会議を1本だけ通して誤りを数えるのが一番早い。
- とりあえず自分の声の通り方を見たい → Nottaの無料枠(月120分・1回3分)
- 2時間の会議を丸ごと回したい → Whisper(MITライセンス。手元のPCで動く)
- 社内システムに組み込みたい → Google Cloud Speech-to-Text(日本語ja-JPは正式提供)
議事録の文字起こしをAIに投げて、戻ってきたテキストを見て固まった経験。あれは、たいてい音声のせいです。ツールを変える前に、どこで何回間違えたかを数えると話が早く進みます。
この記事の目次
会議の音声だと、AIはどれくらい間違えるのか
先に結論。読み上げ音声の評価値を見て「ほぼ完璧」と思っていると、会議音声で落差にやられます。
ソニーグループの研究チームがarXivで公開した多言語ASRモデルの論文に、日本語話し言葉コーパス(CSJ/学会講演と模擬講演の録音)での比較表があります。ここでのWhisper large-v3の文字誤り率は16.5〜18.4%。100文字書き起こして16〜18文字ずれる計算です。
正直、この数字は見た瞬間に「思ったより高い」と感じました。CSJはフィラー(「えー」「あのー」)や言い直しが多く、雑に言えば「一人がしゃべる会議」に近い音声です。読み上げ音声のベンチマークだけ見ていると、まったく別物に見えます。
Notta側の説明はもっと具体的でした。公式ブログには、整然と発言するフォーマルな会議で認識率90%以上、軽いミーティングや打合せでは50〜80%程度、と書かれています。トップページの「98%+ Accuracy Guaranteed」とは別に、この幅をちゃんと出しているのは誠実だと思います。
| 音声の種類 | 公表されている目安 | 出どころ |
|---|---|---|
| 学会講演・模擬講演 | 文字誤り率 16.5〜18.4%(Whisper large-v3) | ソニーグループの論文(arXiv) |
| 整然としたフォーマルな会議 | 認識率 90%以上 | Notta公式ブログ |
| 軽いミーティング・打合せ | 認識率 50〜80%程度 | Notta公式ブログ |
← 表は横にスクロールできます →
指標も測定条件も違うので、横に並べて優劣は付けられません。それでも共通して言えるのは、会議の種類のほうがツールの差より大きいということです。
Whisper・Notta・Googleは、そもそも何が違うのか
3つは競合というより、立ち位置が違います。使う側が用意するもの(お金・時間・技術)が全部ちがう。
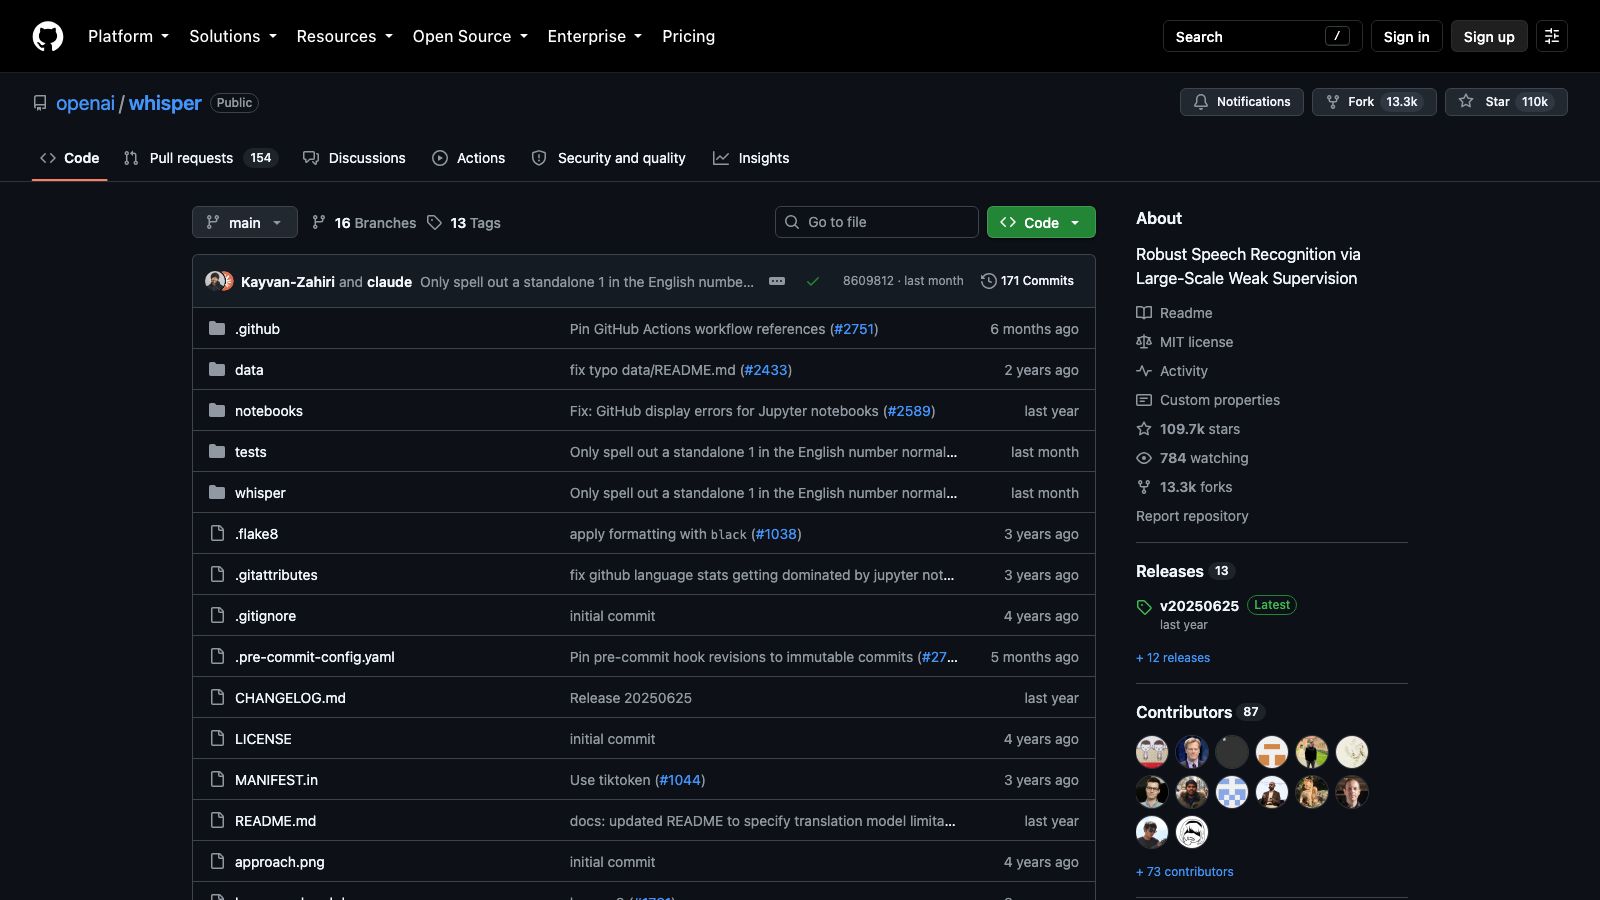
Whisperは公式リポジトリでtiny/base/small/medium/large/turboの6サイズが公開されています。コードもモデルの重みもMITライセンス。largeは10GB程度のVRAMが要る一方、turboは約6GBで速度はlargeの8倍程度と書かれています。
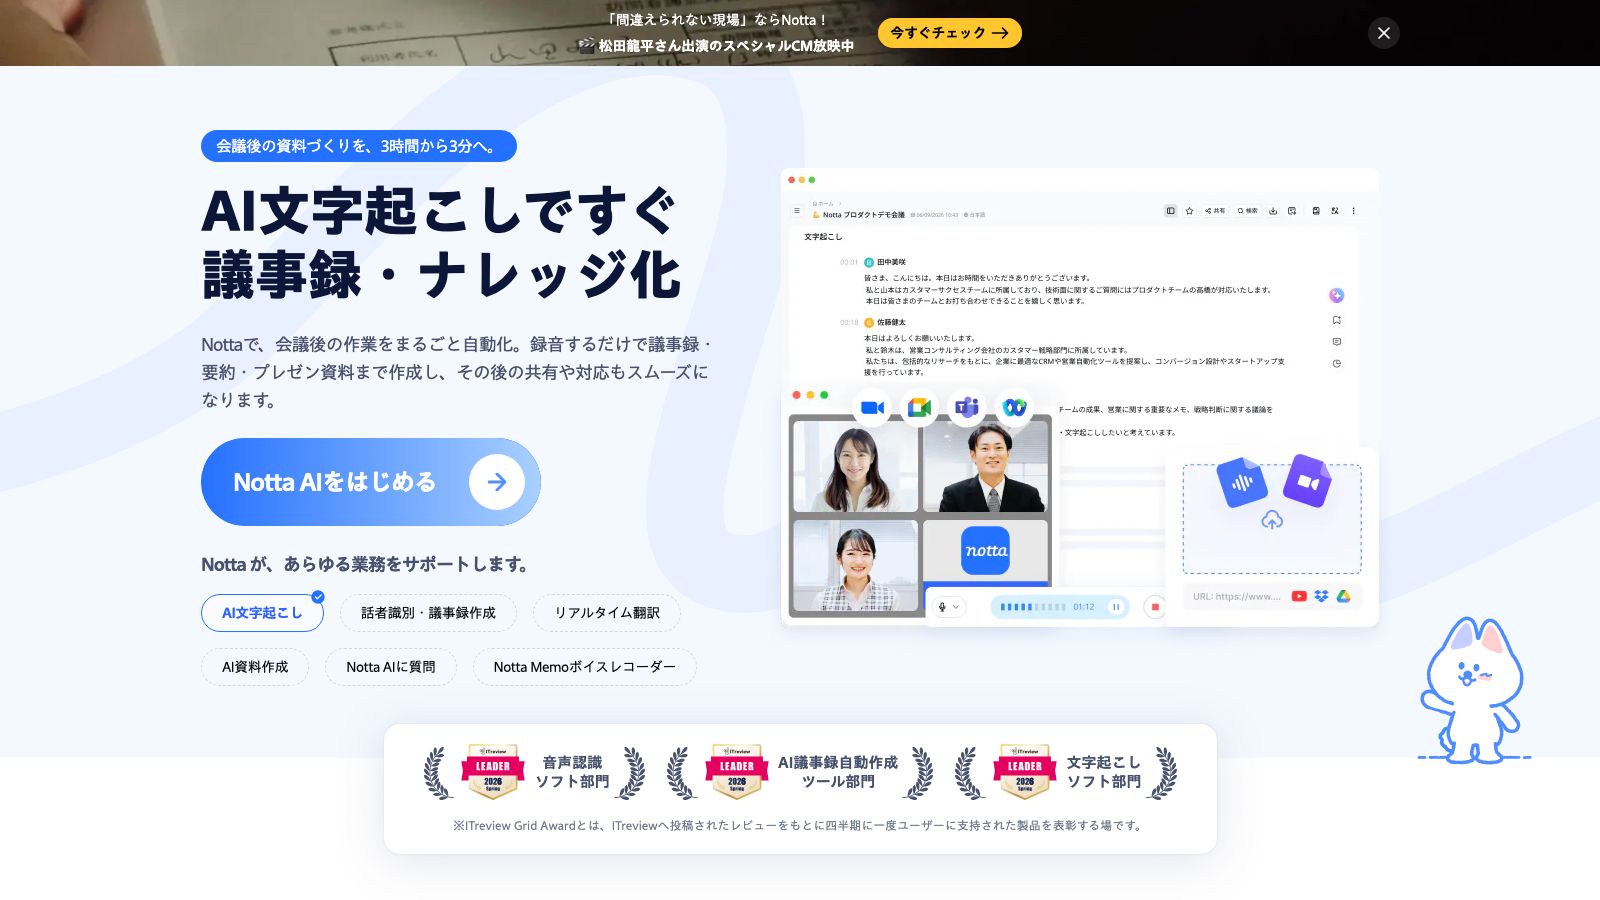
Nottaは58言語対応をうたい、Zoom・Google Meet・Microsoft Teams・Webexとの連携を掲げています。リアルタイム文字起こしもあります。文字起こしそのものより、会議に自動で入って勝手に録る部分が本体だと思ったほうが実態に近い。
Googleは最新世代のChirp 3で、日本語(ja-JP)が文字起こし・話者分離ともに一般提供(GA)になっています。自動句読点、自動言語検出、ノイズ低減もGA。ただし単語単位のタイムスタンプと単語単位の信頼度スコアは非対応です。
ここは地味に効きます。動画の字幕を1語ずつ動かしたい制作案件だと、この一点でGoogleが外れることがある。一方Whisperは、whisper-1系で単語またはセグメント単位のタイムスタンプが取れます。
自分の会議音声で「誤りの数」を数える手順
他人のベンチマークは参考値です。あなたの会議室の反響と、あなたの業界の固有名詞では結果が変わります。だから数えます。
正解となる見本(正解テキスト)を手で作るのが一番しんどい工程です。3分あれば十分。10分作ると心が折れます。
数えるときのコツは、種類ごとに分けて数えること。合計のパーセントだけ見ても、直す手間が想像できません。固有名詞のミスは辞書登録で潰せますが、声のかぶりによる脱落は録り方を変えるしかない。原因が違えば打ち手も違います。
比較するときは条件を揃えてください。同じファイル、同じ言語指定、同じ話者数。片方だけ用語登録を入れると、それはツールの比較ではなく設定の比較になります。
結局いくらかかるのか(無料枠でどこまで届くか)
月に何時間の会議を回すかで、答えがきれいに割れます。2026-09-28時点の各社公式ページの表記です。
| 無料でできる範囲 | 有料の入口 | 引っかかりやすい制限 | |
|---|---|---|---|
| Whisper(自分のPC) | 制限なし(MITライセンス) | 0円(電気代と機材) | largeは約10GBのVRAM |
| Whisper API(OpenAI) | なし | $0.006/分 | 1ファイル25MBまで |
| Notta | 月120分・1回3分 | 年払い月1,185円で月1,800分 | 1回5時間まで |
| Google Speech-to-Text | 月60分(V1 API) | 従量課金 | 最新価格は公式ページで確認 |
← 表は横にスクロールできます →
Nottaのプレミアムは年払いで月1,185円。時給3,000円で請求している人なら、月に24分浮けば元が取れます。会議1本の書き起こし直しが30分かかるなら、1本目で回収できる計算です。
無料枠の落とし穴は「1回3分」のほう。月120分あっても、1時間の会議は1本も通りません。App Storeのレビューにも「お試しは3分だけです」と書いた投稿があり、会議の途中で止まって慌てた話が添えられていました。
OpenAIのAPI側は1ファイル25MBの上限があります。長い会議は分割が前提。ここは最初に知っておくと、あとで慌てません。
誤りが出る場所は、だいたい決まっている
パーセントより、こっちのほうが実務では役に立ちます。ずれる場所には偏りがある。
Notta公式ブログのサンプル検証でも、「Notta」を「乗った」と認識した以外は正確に書き起こせた、という書き方をしています。逆に言えば、固有名詞さえ潰せば残りは読めるということです。
App Storeのレビューには「文字起こしの精度はあまりよいとは言えません。専門用語は特にとらえられないようです」という声もありました。用語登録を入れる前と後で、体感がかなり変わる領域だと思います。
対処の順番としては、辞書・キーワード指定が先。次にマイクの位置。モデルを大きくするのは最後でいい、というのが調べた範囲での印象です。
なお、社内の会議音声をクラウドに上げる話は別の判断が要ります。Nottaは公式のセキュリティページでISO 27001、SOC 2 Type II、GDPR・APPI対応を掲げ、バックアップデータは国内のデータセンターで保存すると書いています。手元で完結させたいならWhisperをローカルで動かす選択になります。
よくある質問
Q. 無料のまま1時間の会議を文字起こしできますか
Nottaの無料枠は1回3分までなので、そのままでは通りません。手元のPCでWhisperを動かす方法なら、長さの制限はモデルとPCの性能次第になります。
Q. Whisperはどのサイズを選べばいいですか
公式リポジトリの表では、largeが約10GBのVRAM、turboが約6GBでlargeの8倍程度の速度とされています。会議音声を数多く回すなら、まずturboで誤りを数えてから判断するのが手堅い。
Q. 話者ごとに分けたいときは
GoogleのChirp 3は日本語の話者分離がGA(BatchRecognizeまたはRecognizeメソッド)です。Nottaは話者識別が機能に含まれています。OpenAI側は話者分離に対応した専用モデルが用意されています。
次に読むなら
- 議事録AIツールの比較まとめ|このページで誤りを数えたあと、「会議連携と要約まで含めてどれを契約するか」を決める段階の記事です
- Whisperを手元のPCで動かす手順|月の会議時間が30時間を超えて、ローカル運用に倒すことにした人向けです
この記事のまとめ
- 会議音声の誤りは、ツールの差より音声の種類で大きく動く
- 公開されている評価では、講演音声でWhisper large-v3の文字誤り率は16.5〜18.4%
- Notta公式は、フォーマルな会議で認識率90%以上、軽い打合せで50〜80%程度としている
- 無料で確かめるなら、Nottaの月120分枠かWhisperのローカル実行。ただしNottaは1回3分の壁がある
- 次の一手: 自分の会議を3分だけ手で書き起こして見本を作り、同じ音声を2つ以上に通して誤りを数える
出典
- openai/whisper(モデル一覧・VRAM・ライセンス)OpenAI / GitHub / 2026-09-28参照
- API Pricing(音声文字起こしモデルの分単価)OpenAI / 2026-09-28参照
- Speech to text(ファイルサイズ上限・タイムスタンプ・話者分離モデル)OpenAI / 2026-09-28参照
- Notta 料金プラン(無料枠120分・1回3分/プレミアム月1,185円)Notta / 2026-09-28参照
- Notta 公式トップページ(98%+ Accuracy・58言語・Web会議連携)Notta / 2026-09-28参照
- Nottaの文字起こし精度(会議形式ごとの認識率・「乗った」の誤認識例)Notta / 2026-09-28参照
- Notta セキュリティ(ISO 27001・SOC 2 Type II・国内データセンター保存)Notta / 2026-09-28参照
- Chirp 3(ja-JPの文字起こし・話者分離の提供状況、単語単位タイムスタンプ非対応)Google Cloud / 2026-09-28参照
- Google Cloud 無料枠の一覧(Speech-to-Text V1 APIの月60分)Google Cloud / 2026-09-28参照
- Whale: Large-Scale multilingual ASR model(CSJでのCER比較表 Table 3)Sony Group Corporation / arXiv / 2026-09-28参照
- Notta アプリのApp Storeレビュー(精度・専門用語・無料版3分の制限)Apple / App Store / 2026-09-28参照