ツール一覧 / AI活用ノート / AIに表を作らせると崩れる理由|列を先に定義するプロンプト
AIに表を作らせると崩れる理由|列を先に定義するプロンプト
AIに作らせた表の列がずれる・毎回変わるのは、プロンプトの上手さではなく表フォーマットの仕様が原因です。失敗例と成功例、Markdown/CSV/TSV/JSONの使い分け、APIで列を固定するStructured Outputsの仕様差までまとめました。
同じプロンプトで3回表を作らせたら、3回とも列の数が違った。しかも見た目は普通の表なので、スプレッドシートに貼るまで気づかない。
この記事の結論
先に結論を3行で。
- 人が読むだけなら Markdown。列名・列順・列数を先に書いて渡す
- Excelやスプレッドシートに貼るなら TSV(タブ区切り)。CSVより事故が少ない
- プログラムで処理するなら、プロンプトで頼まず APIのStructured Outputs に列をスキーマとして渡す
この記事の目次
選定基準:何を見て「これ」と言っているか
順番や優劣を書く前に、何を物差しにしたかを先に置きます。
- 判断の根拠は、各社の公式ドキュメントとRFC 4180・GitHub Flavored Markdownの仕様に書かれている記述です
- 価格や知名度、シェアは基準に入れていません。どれを選んでも追加費用が発生する話ではないためです
- 書き味や体感速度のような、実際に課金して比べないと言えない要素も順位の材料にしていません
つまりここで言う「向き・不向き」は、あくまで仕様として何が保証され、何が保証されないかの比較です。
崩れた表は、エラーを出さずに出てくる
ここでは「なぜ気づけないのか」を仕様の側から見ます。犯人はモデルの気まぐれだけではありません。
GitHubが公開しているGitHub Flavored Markdownの仕様には、表の行についてこう書かれています。ヘッダ行より少ないセルしかない行には空セルが挿入され、多い分は無視される。そしてヘッダ行と区切り行(---|---の行)のセル数が食い違うと、表として認識されない。
つまり 1列多いと黙って捨てられ、1列少ないと黙って空欄になる。警告は出ません。10行×5列の表をチャット画面で目視チェックしても、まず気づけない粒度です。
CSVも同じ構図です。RFC 4180には「ファイル全体を通して、各行は同じ数のフィールドを含むべき」とあり、カンマ・ダブルクォート・改行を含む値はダブルクォートで囲み、値の中のダブルクォートは2つ重ねてエスケープする、と定められています。ここが厄介で、AIが金額を 1,099.90 と桁区切り付きで書いた瞬間に、その行だけ1列ずれます。
OpenAIの開発者フォーラムには、表の出力について「表では最後のセル(たとえば10行目5列目)が空欄か欠けていることが多い」という不具合報告が上がっています。生成が長くなるほど、末尾が痩せる。これは指示の書き方以前の話です。
失敗するプロンプトと、崩れないプロンプト
この章では、実際に書き換える箇所を4つに絞ります。
書き換え後は、こんな形になります。
## 出力形式
- Markdownの表。列は次の4つ、この順番で固定します。
  1. ツール名(文字列)
  2. 月額(半角数字のみ。円記号・カンマは入れない。不明なら - )
  3. 無料枠(あり / なし / 条件付き のいずれか1語)
  4. 出典URL(https で始まるURLを1本だけ)
- 1ツールにつき1行。全部で5行。
- 表の前後に説明文を書かない。
- 値の中に | を使わない。必要なら全角の | に置き換える。
4つのうち、効きが大きいのは3番だと思います。理由は単純で、空欄の表記が「-」「不明」「N/A」「調査中」で混ざった表は、後からフィルタも並べ替えもできないからです。列がずれるより地味に面倒で、しかも見た目は崩れていないので発見が遅れます。
Anthropicの公式ドキュメントも、出力形式の制御について「してほしくないことではなく、してほしいことを伝える」と書いています。「崩さないでください」ではなく「4列、この順番で」と書く。同じページでは、プロンプト自身の書式が出力の書式に影響するとも説明されています。表がほしいなら、指示の中にも整った箇条書きを置いたほうがいい、という話です。
Markdown、CSV、TSV、JSON。どれで出させるか
先に挙げた3つの基準――①読むのは人か機械か ②値にカンマや改行が入りうるか ③列がずれたときに気づけるか――を、そのまま当てはめます。
| 形式 | 向いている用途 | 弱点 | 値にカンマが入ったら |
|---|---|---|---|
| Markdown表 | チャットで読む、記事に貼る | 列数のずれが無警告。|を含む値に弱い |
影響なし |
| CSV | 配布、他ツールへの取り込み | 区切り文字が環境依存。引用符のルールが複雑 | 引用符で囲まないと全列ずれる |
| TSV | Excel・スプレッドシートへ貼る | 一部エディタでタブが空白に変換される | 影響なし |
| JSON(スキーマ付き) | プログラム処理、DB投入 | 人が目で読むには冗長 | 影響なし |
← 表は横にスクロールできます →
CSVを第一候補にしない理由は、Microsoftの公式ページに書かれています。ブックをCSVとして保存したときの既定の区切り文字(リスト区切り記号)はカンマですが、Windowsの地域設定を変えると変わる。そのため同ページでは、システム設定をいじらずExcel側で区切り記号を変更する手順まで案内されています。「カンマ区切り」は思ったほど一意ではないということです。
一方でタブは、日本語の文章の中に自然発生しません。スプレッドシートに貼るだけなら、TSVで出させるのが一番揉めないと思います。カンマのエスケープ規則をAIに守らせるより、そもそも衝突しない文字を選ぶほうが早い。
なお、OpenAIの開発者フォーラムでも「Playgroundでは表として整形されずプレーンテキストで返ってくる」という質問に対し、Markdownで出してコピーする方法と、CSVで出させてExcelに取り込む方法が挙げられていました。画面が表を描画してくれるかどうかは、モデルではなく表示側の都合です。
APIから使うなら、プロンプトではなく列定義そのものを渡す
ここからは開発者向けです。プロンプトで「この列で」と頼むのをやめて、列の定義をAPIのパラメータとして渡す方法に切り替えます。
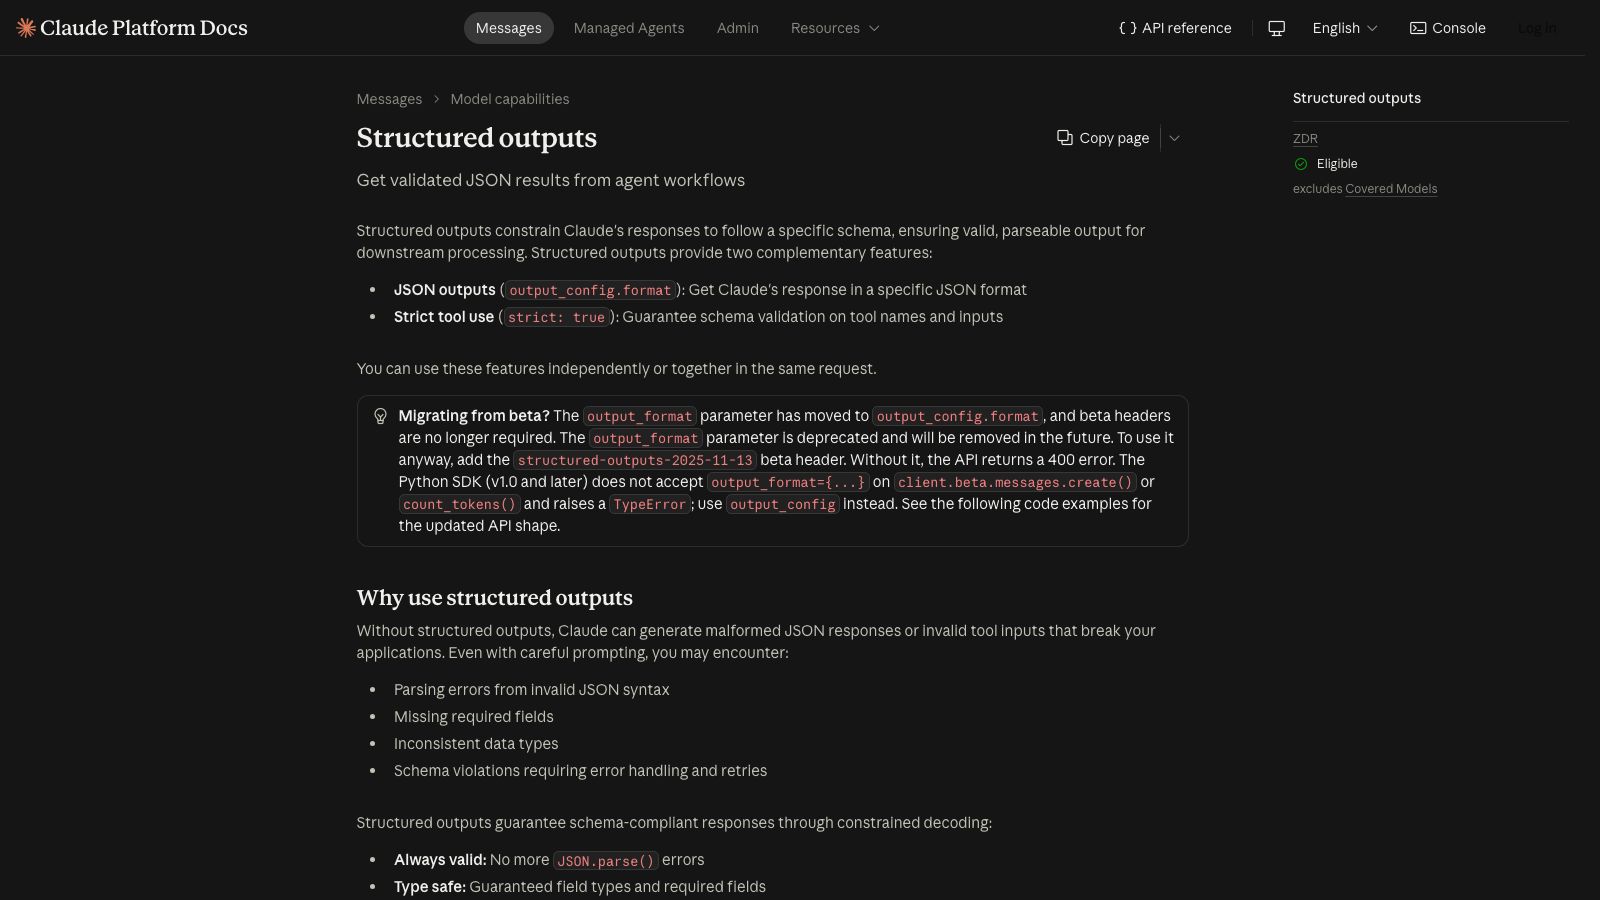
Anthropicのドキュメントは、この機能を「スキーマに従うようClaudeの応答を制約し、下流の処理でそのまま扱える出力を保証する」ものとして説明しています。利点として挙げられているのは3つ。JSON.parse のエラーが起きない、フィールドの型と必須が保証される、スキーマ違反によるリトライが不要になる。
OpenAI側も同じ方向です。公式ガイドでは、旧来のJSONモードが「valid なJSONである」ことしか保証しないのに対し、Structured Outputsは「与えたJSON Schemaに常に従う」と説明されています。
主要3社の仕様を並べます(いずれも2026-09-16時点、各社の公式ドキュメント記載)。
| Claude | OpenAI(Azure版ドキュメント基準) | Gemini | |
|---|---|---|---|
| 呼び方 | Structured Outputs / strict tool use | Structured Outputs(strict: true) |
Structured outputs(responseSchema) |
additionalProperties |
false のみ |
false 固定 |
サポート対象に記載あり |
| 任意の列 | anyOf で null 許容にする |
全フィールドを required にし、["string","null"] で代用 |
required を指定 |
| 列の並び順 | スキーマ順 | スキーマ順(並べ替えたければスキーマ側を並べ替える) | Gemini 2.5以降はスキーマのキー順を保持 |
| 数値の範囲指定 | 非対応(minimum/maximum/multipleOf) |
非対応 | 数値制約に対応と発表 |
| 規模の上限 | ドキュメントに明記なし | オブジェクトのプロパティ合計100、ネスト5階層まで | ドキュメント参照 |
← 表は横にスクロールできます →
ドキュメントの奥にある、面倒な話
ここは読み飛ばされがちですが、実装で詰まるのはたいていこの5つです。
「全部必須」がデフォルト。 Azure OpenAIのドキュメントは「すべてのフィールドまたは関数パラメータを required に含めること」と明記しています。任意の列がほしければ "type": ["string", "null"] のようにnullを許す型にする、という回避策も同じページに書かれています。「空欄にしていい列」を素直に表現できないのは、最初につまずくところです。
桁区切りはスキーマでは止められない。 Claudeのドキュメントの非対応リストには minimum / maximum / multipleOf / minLength / maxLength が並んでいます。配列の minItems も0と1しか使えない。つまり「月額は半角数字のみ、カンマなし」は、スキーマではなく指示文で伝えるしかありません。型は縛れても、書式は縛れない。この線引きは押さえておいたほうがいいと思います。
列の順番。 Googleは2025年11月5日の公式発表で、JSON Schema対応の拡大とあわせて「APIはスキーマのキーの順序と同じ順序を保持する」と announce しました。対象はGemini 2.5以降です。逆に言うと、それ以前の世代は違う。Gemini 2.0については、公式ドキュメントに「明示的な propertyOrdering リストが必要」という注記があります。Googleの開発者フォーラムにも、OpenAI互換エンドポイント経由だと「レスポンスのプロパティ順がランダムに見える」という投稿があり、理由付けの列を先に出させたいのに出せない、と困っている様子でした。順番を前提に組んでいると刺さります。
prefillは引き上げられた。 出力の先頭を自分で書き始めて形式を強制するprefillは、長く使われてきた手です。Anthropicのドキュメントには「Claude 4.6以降のモデルではprefillはサポートされない」という注記があり、Structured Outputsかシステムプロンプトでの指示に移行するよう案内されています。古い記事のテクニックをそのまま持ってくると動きません。
並列ツール呼び出しとは同時に使えない。 Azure OpenAIのドキュメントは、Structured Outputs利用時は parallel_tool_calls を false にするよう明記しています。
そのままコピペできる指示テンプレ
チャットで表がほしいとき用。【】の中を置き換えて使えます。
以下の条件で表を作ってください。

## 列の定義(この順番、この本数で固定)
1. 【列名1】(型:文字列 / 例:〇〇)
2. 【列名2】(型:半角数字のみ。単位・カンマは書かない。不明なら - )
3. 【列名3】(型:次の3語のいずれか — あり / なし / 条件付き)

## 出力ルール
- 形式は【Markdownの表 / タブ区切り(TSV)】。
- ヘッダ行を1行目に置き、2行目以降にデータを書く。
- 行数は【N】行。過不足があれば、不足分は値を - にして行を埋める。
- 値の中に区切り文字(| またはタブ)を入れない。
- 表の前後に説明文・前置き・まとめを書かない。
- 出力し終えたら、最終行の列数がヘッダと一致しているか確認してから出す。
最後の1行を足しておくと、末尾が痩せる問題にいくらか効きます。Anthropicのドキュメントも、出力前に自己検証させる指示は有効だとしています(ただし新しい世代のモデルでは過剰な検証を招くので外したほうがいい、とも書かれています)。
よくある質問
Q. 無料のチャット版でもStructured Outputsは使えますか。 いいえ。これはAPIの機能です。チャット画面で使えるのは、この記事の前半にある「列を先に定義するプロンプト」までです。逆に言えば、列名・型・空欄表記を書くだけなら追加費用はかからないので、まずそこからで足ります。
Q. 表を作り直させるたびに列が変わってしまいます。 「前の表に列を追加して」と頼むと、モデルは表全体を作り直します。列定義のブロックを毎回プロンプトの先頭に貼り直すほうが安定します。定義を会話の履歴に埋もれさせない、という単純な話です。
Q. ExcelにMarkdownの表を貼ると1セルに全部入ってしまいます。
Markdownは区切り文字がタブでもカンマでもないので、そのままでは列に分かれません。最初からTSVで出させるか、Excelの「データ」→「区切り位置」で | を区切り文字に指定してください。
Q. CSVとTSV、結局どちらを頼むべきですか。 値に金額・住所・日本語の文章が入るならTSVです。Microsoftの案内どおりCSVの区切り文字は環境設定の影響を受けますし、カンマを含む値は引用符で囲む必要があります。その規則をAIに完璧に守らせるより、衝突しない区切り文字を選ぶほうが確実だと考えています。
Q. 列を定義すれば中身の正しさも保証されますか。 されません。保証されるのは「形」だけです。Anthropicのドキュメントが保証すると書いているのも、スキーマへの準拠であって内容の正確さではありません。数値や出典は別途確認が要ります。
この記事のまとめ
- Markdownの表は、列が多ければ無視され、少なければ空欄で埋められる。エラーは出ないので目視では気づけない
- プロンプトでは「列名・列順・列数・各列の型・値が無いときの表記」を先に書く。特に空欄表記の統一が効く
- Excelに貼るならTSV。CSVの区切り文字は環境設定に依存すると、Microsoftの公式ページが説明している
- APIから使うならStructured Outputsで列定義をスキーマとして渡す。ただし保証されるのは形であって、桁区切りなどの書式や内容の正しさは別
- 列順の保証、任意列の扱い、prefillの廃止は提供元ごとに違う。2026-09-16時点の各社ドキュメントで確認を
次にやることを1つだけ挙げるなら、いつも使っている表作成のプロンプトの先頭に、この記事の「列の定義」ブロックを貼ってみてください。3回まわして列が揃うかどうかで、効いているかはすぐ分かります。
出典
- Structured outputs - Claude API DocsAnthropic / 2026-09-16参照
- Structured model outputs | OpenAI APIOpenAI / 2026-09-16参照
- How to use structured outputs with Azure OpenAI in Microsoft Foundry ModelsMicrosoft / 2026-09-16参照
- RFC 4180 - Common Format and MIME Type for Comma-Separated Values (CSV) FilesRFC Editor / IETF / 2026-09-16参照
- GitHub Flavored Markdown Spec(Tables 拡張)GitHub / 2026-09-16参照
- Structured outputs | Gemini APIGoogle / 2026-09-16参照
- Structured outputs | Gemini Generate Content API (Legacy)Google / 2026-09-16参照
- Improving Structured Outputs in the Gemini API(2025年11月5日)Google / 2026-09-16参照
- Increase output consistency - Claude Platform DocsAnthropic / 2026-09-16参照
- Prompting best practices - Claude Platform DocsAnthropic / 2026-09-16参照
- Import or export text (.txt or .csv) files(区切り文字は地域設定に依存する旨の記載)Microsoft / 2026-09-16参照
- 開発者フォーラムの投稿「propertyOrdering が OpenAI互換APIで守られない」Google AI Developers Forum / 2026-09-16参照
- 不具合報告「表の最後のセルが空欄または欠ける」OpenAI Developer Community / 2026-09-16参照
- 質問「Playgroundで表として出力させるには」OpenAI Developer Community / 2026-09-16参照