ツール一覧 / AI活用ノート / AI検索に自社サイトを載せる方法|公式が示す条件とllms.txtの扱い
AI検索に自社サイトを載せる方法|公式が示す条件とllms.txtの扱い
AI OverviewsやChatGPT検索に自社サイトが引用される条件を、Google・OpenAI・Anthropic・Perplexity・Microsoftの公式ドキュメントだけを根拠に整理します。llms.txtを置くべきかの判断材料と、載っているか確認する場所もまとめました。
「ChatGPTで検索しても自社が出てこない」。この相談に対する各社の公式な答えは、思っているより短いです。新しいファイルを作る話ではありませんでした。
結論: 専用ファイルを作る前に、robots.txt とインデックス状況を見る。
- まず見る → robots.txt でAI検索用のクローラーを塞いでいないか
- 次に見る → Search Console の「生成AI」レポート
- 当面は後回しでいい → llms.txt(Google検索は使わないと公式に書かれています)
この記事の目次
AI検索に載る条件は、ほとんど増えていない
ここで分かるのは「何を満たせば出る資格があるのか」です。結論、Googleが挙げているのは3つだけでした。
Google 検索セントラルの「AI Features and Your Website」には、AI機能に出るための追加要件はないと書かれています。必要なのはインデックス登録と技術要件、そしてスニペット(検索結果に出る抜粋文)表示の対象であること。つまり既存のSEOの延長線上です。
同じことを、Googleは別ページでもう一歩強く書いています。
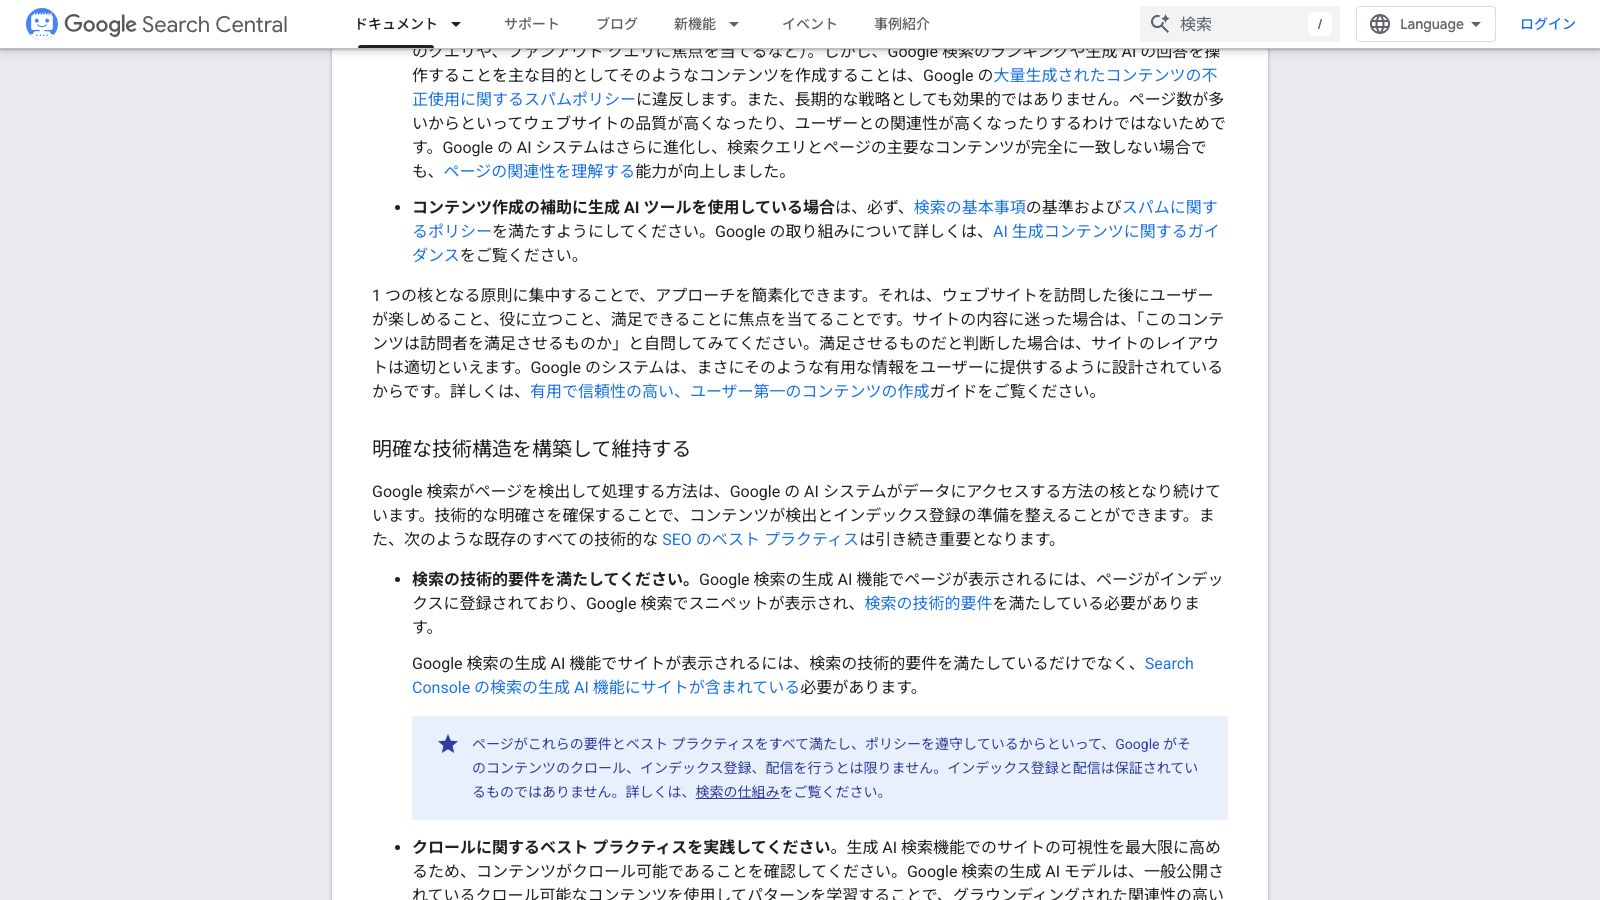
「生成AI最適化ガイド」には俗説を否定する節があり、そこには "You don't need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search" とあります。機械可読ファイルもマークダウンも不要、という言い方です。構造化データについても "Structured data isn't required for generative AI search" と書かれています。
正直、ここまで明確に「不要」と列挙している公式ドキュメントは珍しいと感じました。それだけ現場で誤解が多いという裏返しでしょう。
| Googleが「不要」と書いていること | 原文のキーワード |
|---|---|
| llms.txt など専用ファイル | machine readable files, AI text files |
| AI向けの特別なマークダウン | Markdown |
| 生成AI用の構造化データ | Structured data isn't required |
| コンテンツを細かく刻むこと | tiny pieces |
| AI向けの特別な文体 | write in a specific way |
| 不自然な言及集め | inauthentic "mentions" |
← 表は横にスクロールできます →
llms.txt は置くべきか
ここで分かるのは「llms.txtを作る工数を今かけるべきか」です。答えは、Google検索を目的にするなら不要です。
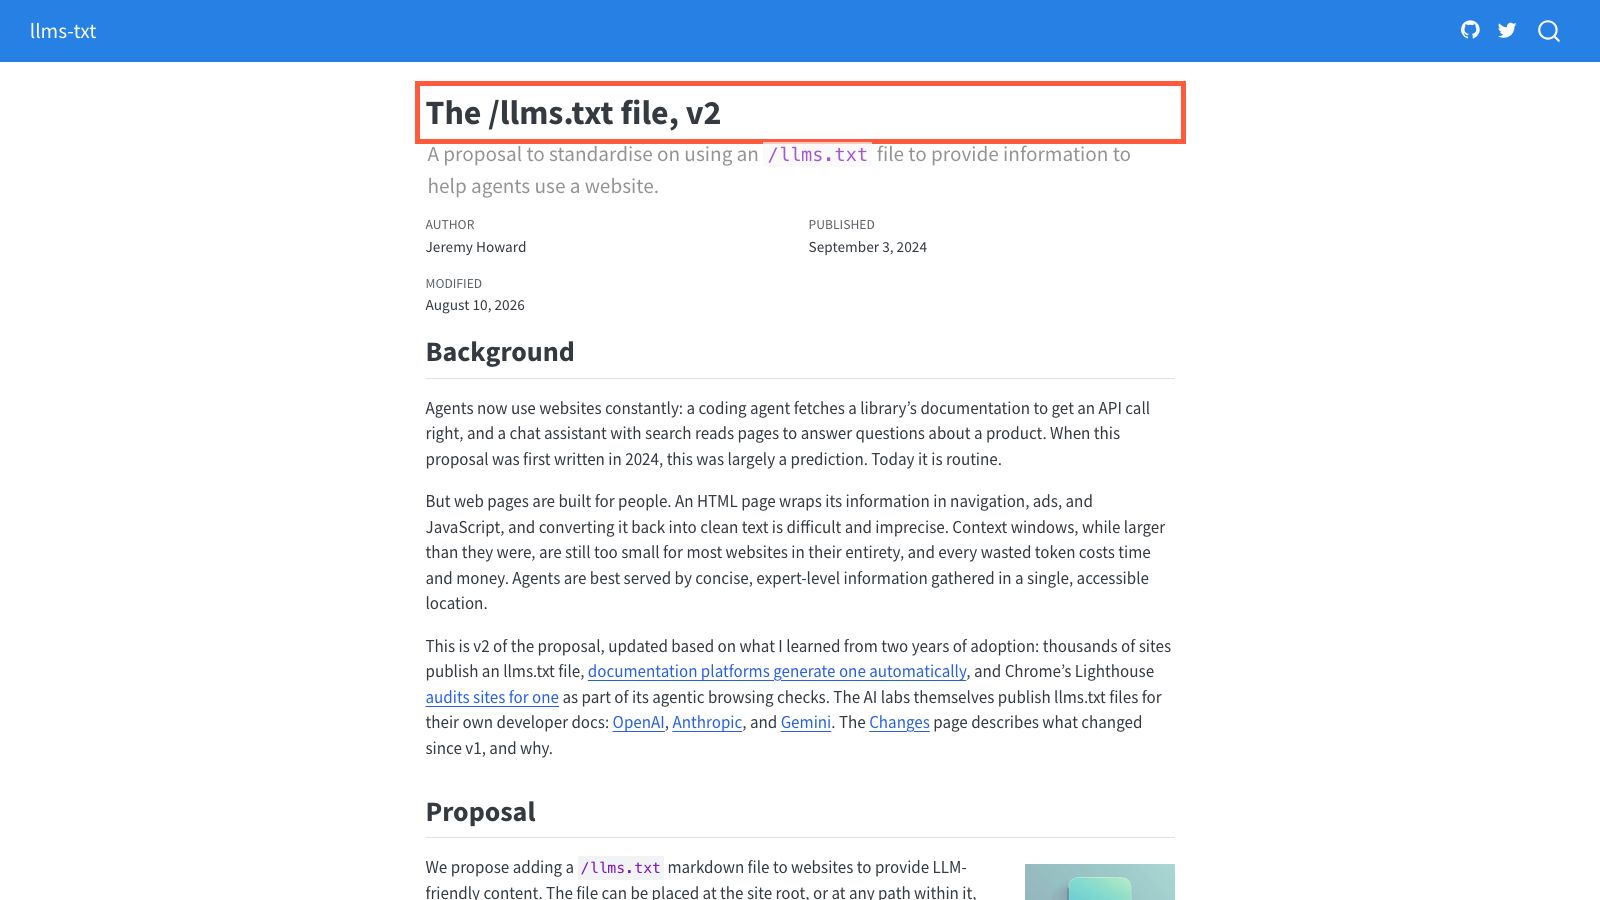
llms.txt は、サイトの中身をLLM(大規模言語モデル)向けに整理したMarkdownファイルを置くという提案です。仕様ページには、H1が必須で、要約のブロッククォートとH2ごとのリンク一覧が続く、と書かれています。仕様そのものはシンプルで、読みやすいです。
Googleの生成AI最適化ガイドには、llms.txt を Google検索は使わない、と書かれています。他のサービス向けに置くのは問題ないが検索への影響はない、という整理です。OpenAI・Anthropic・Perplexity の公開ドキュメントにも、llms.txt を読んでいるという記述は見つかりませんでした。
運用面の落とし穴も報告されています。llms.txt の仕様リポジトリのissueには、公開ディレクトリに登録されたファイルを6週間あけて2回クロールした記録があり、HTMLを返してしまうURLが32件から60件に増えたとあります。投稿者はこう書いています。「200を返すのでステータス確認では問題なく見えるが、取得したエージェントにはマークアップが渡る」。公開した側からは見えない壊れ方だ、という指摘です。
標準化の議論も途上です。W3Cのstrategyリポジトリには llms.txt を扱うissueが立っていますが、/.well-known/ の慣習と食い違う点や、多言語サイトの扱いが論点として残っています。
個人的な判断としては、技術ドキュメントを公開していて「AIに正しく読ませたい資料」がある会社なら置く価値があります。コーポレートサイトやサービスLPの集客目的なら、今は後回しで構わないと思います。
やることは robots.txt の確認。クローラーは1社で3種類ある
ここで分かるのは「どのクローラーを通せばAI検索の対象になるか」です。学習用と検索用が別物なのが肝心です。
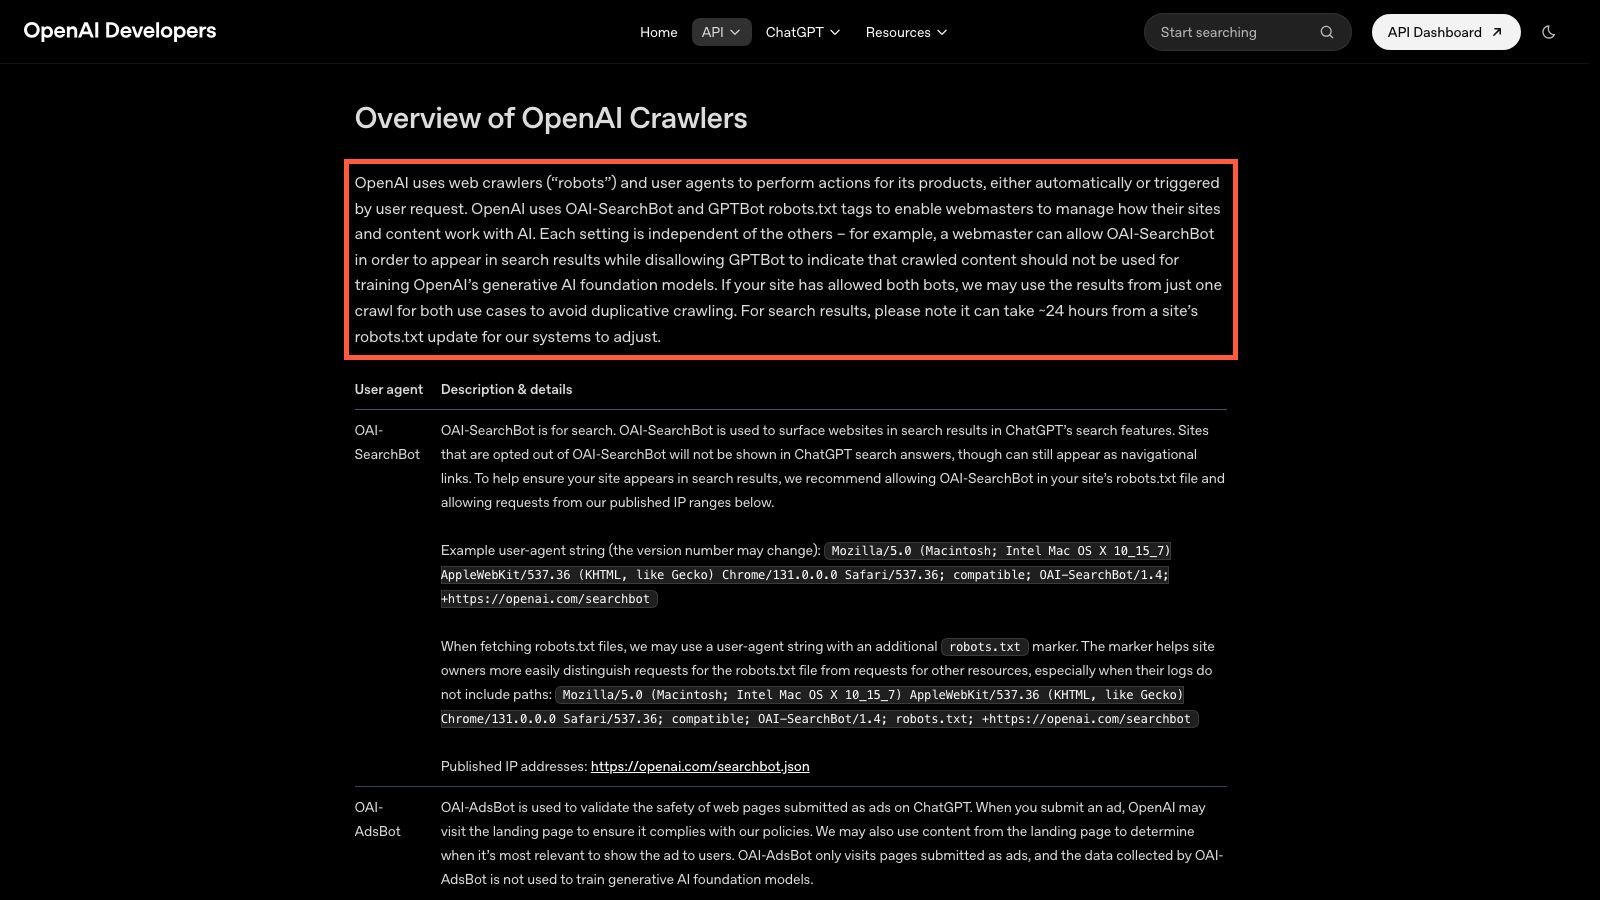
OpenAIのドキュメントでは、OAI-SearchBot は "used to surface websites in search results in ChatGPT's search features" と説明され、学習には使われないと書かれています。GPTBot は学習用で、こちらを拒否すれば学習に使われない扱いです。ChatGPT-User はユーザーの質問に応じてページを見に行くもので、robots.txt のルールが適用されない場合があると明記されています。
Anthropic も同じ三分割です。公式サポート記事では ClaudeBot がモデル開発用、Claude-User がユーザーの質問時の取得、Claude-SearchBot が検索品質の向上のための解析と説明されています。Anthropic側は robots.txt の業界標準ディレクティブを尊重すると書いています。
Perplexity は PerplexityBot が検索結果での表示用、Perplexity-User がユーザー操作時の取得です。後者は「ユーザーがリクエストしたため一般に robots.txt を無視する」と書かれています。この線引きが各社でそろっていないのは、地味に見落としがちな点です。
| 提供元 | 検索用(通したい) | 学習用(止めてもAI検索に影響しない) |
|---|---|---|
| Googlebot | Google-Extended | |
| OpenAI | OAI-SearchBot | GPTBot |
| Anthropic | Claude-SearchBot | ClaudeBot |
| Perplexity | PerplexityBot | — |
← 表は横にスクロールできます →
Google-Extended については、Googleが "does not impact a site's inclusion in Google Search nor is it used as a ranking signal" と明記しています。Geminiの学習を断っても検索順位には関係しない、という意味です。
# AI検索には出したい、学習には使われたくない場合の例
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /
自社の robots.txt を開いて、User-agent: * で全部まとめて落としていないか見るのが最初の一手です。ここを直すだけで資格が戻るケースがある、というのが各社の説明から読み取れる話です。
載っているかどうかを確認する場所
ここで分かるのは「表示回数は見られるが、クリックは見られない」という現状です。測れるものと測れないものを先に押さえておくと落胆しません。
Search Console の「生成AIパフォーマンスレポート」は、2026年6月に検索セントラルブログで発表されました。公式ヘルプには、2026年8月31日に全世界のサイトへ提供が完了したと書かれています。指標は表示回数が中心で、AI Overviews と AI Mode が対象です。
注意点として、AI機能での表示は通常のPerformanceレポートの「ウェブ」検索タイプにも含まれます。生成AIレポートの数字と足し算すると二重計上になります。
Microsoft側にも同種のレポートがあります。Bing Webmaster Blog の2026年2月の発表によると、AI Performance では引用数、1日あたりの平均引用ページ数、グラウンディングに使われたクエリのサンプル、ページ別の引用状況が見られます。対象は Microsoft Copilot と Bing内のAI要約、および一部のパートナー連携です。
グラウンディングに使われたクエリが見られるのは、Googleのレポートにはない情報です。クエリが分かるかどうかで打ち手の精度は変わるので、ここはBing側のほうが実務で使いやすいと感じました。
Microsoftは、AI回答への掲載と引用には最新のコンテンツであることが大事だとして IndexNow を挙げています。IndexNow はURLの追加・更新・削除を検索エンジンに即時通知する仕組みで、Bing、Naver、Seznam.cz、Yandex、Yep が対応しています。
数字を読むときの余談ですが、Googleは「Search Consoleのデータ異常」ページで、2026年8月13日から17日のデータについて、ログのエラーで生成AIレポートの表示回数が減少したと記録しています。急な上下を自社の施策のせいだと決めつける前に、このページを見る習慣は役に立ちます。
AI機能にだけ出したくないときの設定
ここで分かるのは「AI機能だけ外す選択肢が増えた」ことです。順位に影響しない、と明記されている点が重要です。
Search Console の「設定 > Search generative AI」で、サイトのコンテンツを生成AI機能に含めるかどうかを選べます。公式ヘルプでは、除外を選ぶとAI機能の中でユーザーに見えなくなる、と説明されています。反映には数日かかるとも書かれています。
ヘルプには "this control isn't used as a ranking or inclusion signal affecting other parts of Search" とあります。AI機能を切っても通常の検索には使われない、という約束です。
ページ単位で絞りたいなら、従来のプレビュー制御がそのまま効きます。nosnippet、data-nosnippet、max-snippet、noindex です。Googleの「AI Features and Your Website」は、これらでページから表示される情報を制限できると書いています。
ただし、スニペットを止めるとAI機能に出る資格そのものを外すことになります。全サイトで nosnippet を付けるような判断は、検索結果の抜粋表示も一緒に失う話です。ここは案件ごとに、クライアントの意図を確認してから触る領域だと思います。
よくある質問
Q. llms.txt を置けばChatGPTに引用されますか。 各社の公開ドキュメントに、そう書いたものは見つかりませんでした。Googleは生成AI最適化ガイドで、Google検索は llms.txt を使わないと明記しています。ChatGPT検索については、OpenAIがOAI-SearchBotの許可を案内しています。
Q. 学習に使われたくないけれど、AI検索には出たいです。
その書き分けは各社が用意しています。GPTBot と ClaudeBot、Google-Extended を拒否しつつ、OAI-SearchBot・Claude-SearchBot・Googlebot は通す形です。robots.txt は上から順に効くので、User-agent: * の Disallow が全体にかかっていないか確認してください。
Q. AI検索からの流入は数字で追えますか。 表示回数は追えますが、クリック数は現状のレポートに含まれていません。Search Consoleの生成AIレポートは表示回数・ページ・国・デバイス・期間まで、Bing Webmaster Tools の AI Performance は引用数とグラウンディングクエリのサンプルまでです。流入そのものは、アクセス解析側でリファラーを見るのが現実的な手段になります。
もっと詳しく知りたい人へ
Search Console の生成AIレポートの数字は、通常のPerformanceレポートの「ウェブ」検索タイプにも含まれています。AI機能での表示を別立てで足し算すると実態より大きくなります。レポートの位置づけは公式ヘルプの説明に従って読むのが安全です。
llms.txt の標準化は、W3Cのstrategyリポジトリで議論の対象になっています。/llms.txt というパスが /.well-known/ の慣習と食い違う点や、多言語サイトでの扱いが論点です。仕様が固まってから導入を判断しても遅くない段階だと読めます。
価格や設定画面の仕様は変わります。この記事の内容は2026-10-02時点で各社の公式ドキュメントに記載されていたものです。最新の状況は各提供元の公式ページでご確認ください。
次に読むなら
話題が一番近いのは、各社の一次情報そのものです。読む順番だけ提案します。
- Google 検索セントラル「生成AI最適化ガイド」 … 「やらなくていいこと」が列挙されているので、社内で工数の優先順位を決めるときに一番早く効きます。
- OpenAI「Overview of OpenAI Crawlers」 … robots.txt を触る前に、自社がどのボットを止めているか照合するために開くページです。
この記事のまとめ
- AI機能に出る条件としてGoogleが挙げているのは、インデックス・技術要件・スニペット表示の対象の3つ
- Googleは llms.txt や生成AI用の構造化データを「不要」と明記している
- クローラーは「検索用」「学習用」「ユーザー操作時」の3種類に分かれ、書き分けができる
- 表示回数は Search Console と Bing Webmaster Tools で追えるが、クリック数は現状含まれない
- AI機能だけ外す設定が Search Console にあり、通常の検索の判断には使われないと書かれている
今日やることを1つだけ選ぶなら、自社の robots.txt を開いて、検索用のクローラーまで塞いでいないか確かめることです。
出典
- AI Features and Your WebsiteGoogle 検索セントラル / 2026-10-02参照
- Google's Guide to Optimizing for Generative AI Features on Google SearchGoogle 検索セントラル / 2026-10-02参照
- Introducing Search Generative AI performance reports in Search ConsoleGoogle 検索セントラル ブログ / 2026-10-02参照
- Generative AI performance report (Search) - Search Console HelpGoogle / 2026-10-02参照
- Search generative AI control - Search Console HelpGoogle / 2026-10-02参照
- Data anomalies in Search ConsoleGoogle / 2026-10-02参照
- Google crawlers and fetchers(Google-Extended の説明)Google 検索セントラル / 2026-10-02参照
- Overview of OpenAI CrawlersOpenAI / 2026-10-02参照
- Does Anthropic crawl data from the web, and how can site owners block the crawler?Anthropic / 2026-10-02参照
- PerplexityBot / Perplexity-User のドキュメントPerplexity / 2026-10-02参照
- Introducing AI Performance in Bing Webmaster Tools (Public Preview)Microsoft Bing Webmaster Blog / 2026-10-02参照
- The /llms.txt file, v2llmstxt.org / 2026-10-02参照
- IndexNowIndexNow / 2026-10-02参照
- llms.txt の採用状況を6週間あけて2回計測した報告(HTMLを返すURLが倍増)GitHub / AnswerDotAI llms-txt Issues / 2026-10-02参照
- llms.txt の標準化についての議論GitHub / W3C Strategy Issues / 2026-10-02参照